 智能搭子
H3 Director自带9个工作流,我用12GB显卡先跑了两个
大家好,我是你的智能搭子阿洁。
这次又发现了一个值得试试的 MiniMax H3 视频制作工具:H3 Director。它能把人物图片、声音素材和镜头安排放进同一个界面,做视频时,每个镜头用谁、做什么、持续多久,都有对应的位置可以调整。
比如,给它一张咖啡师图片,先安排她放下杯子,再切到近景,抬头看向顾客微笑。这次我就用这段小场景,试了试它的人物参考和双镜头生成。
项目全名是 ComfyUI-MiniMaxH3-Director,由seesee75-commits开发,本次用的是v1.0.0。它还自带了 9个示例工作流:从文字生成、人物与声音参考,到音乐视频、故事板和人物替换,有不少值得继续探索的入口。
我用 RTX 5070 12GB 先跑了其中两个。这篇先带大家看看它能做什么、界面怎么用,再聊聊我实际跑出来的效果和遇到的问题。
这套“导演工具”,负责安排什么?
H3负责生成画面和声音,Director负责组织制作过程:准备人物图或音频,安排每个镜头的内容和时长,再把视频拆成渲染分段,逐段生成并合成输出。
它与我之前做31秒咖啡店短片用的Chain Director是不同项目。这一期介绍的是seesee75-commits这份节点的1.0.0版本。
我觉得它值得先了解的地方,是把几种制作方式放到了同一套操作逻辑中:素材用卡片管理,镜头在时间轴上安排,生成任务按分段执行。 做人物短片,可以引用人物照片;有歌曲,可以围绕音频安排画面;已经画好分镜,也有从图片或故事板开始的入口。
项目附带的9个工作流,各自对应不同任务。下面是项目说明里的用途,其中第1、2个是我今天实际使用的。
| 工作流 | 用来做什么 |
|---|---|
| 1 · Text to video | 从文字开始生成视频,可以安排多个镜头和台词。我用它先做了灯塔单镜头。 |
| 2 · Characters and voice | 用人物图片提供外观参考,用音频提供声音参考。今天的咖啡师双镜头基于它制作,只测试人物参考。 |
| 3 · Music video | 围绕歌曲制作音乐视频,让画面配合固定歌曲,并提供歌词时间定位。 |
| 4 · Shots from pictures | 用图片指定各镜头的开场画面,适合先准备关键画面,再让它动起来。 |
| 5 · Pictures | 按镜头生成静态图片,先检查人物和构图。 |
| 6 · Storyboard | 把带编号的画面和文字组织成故事板,再交给Director安排视频。 |
| 7 · Control video | 利用参考视频的姿态、边缘、深度等信息,约束生成画面的动作或结构。 |
| 8 · Inpaint(replace a figure) | 在已有视频中,用参考人物替换原角色。 |
| 9 · Custom sampling | 将生成循环与ComfyUI原生采样节点结合,供需要调整采样流程的人使用。 |
这些示例是不同的制作入口,不需要从1到9依次运行。只有文字和想法,可以从第1个开始;已有角色图,可以先试第2个;想照着参考视频控制动作,再看第7个。
声音克隆、控制视频、人物替换等功能,我今天还没有逐项跑。它们在12GB显卡上的表现,也要留到后续实际验证。
打开界面后,先看这三个区域
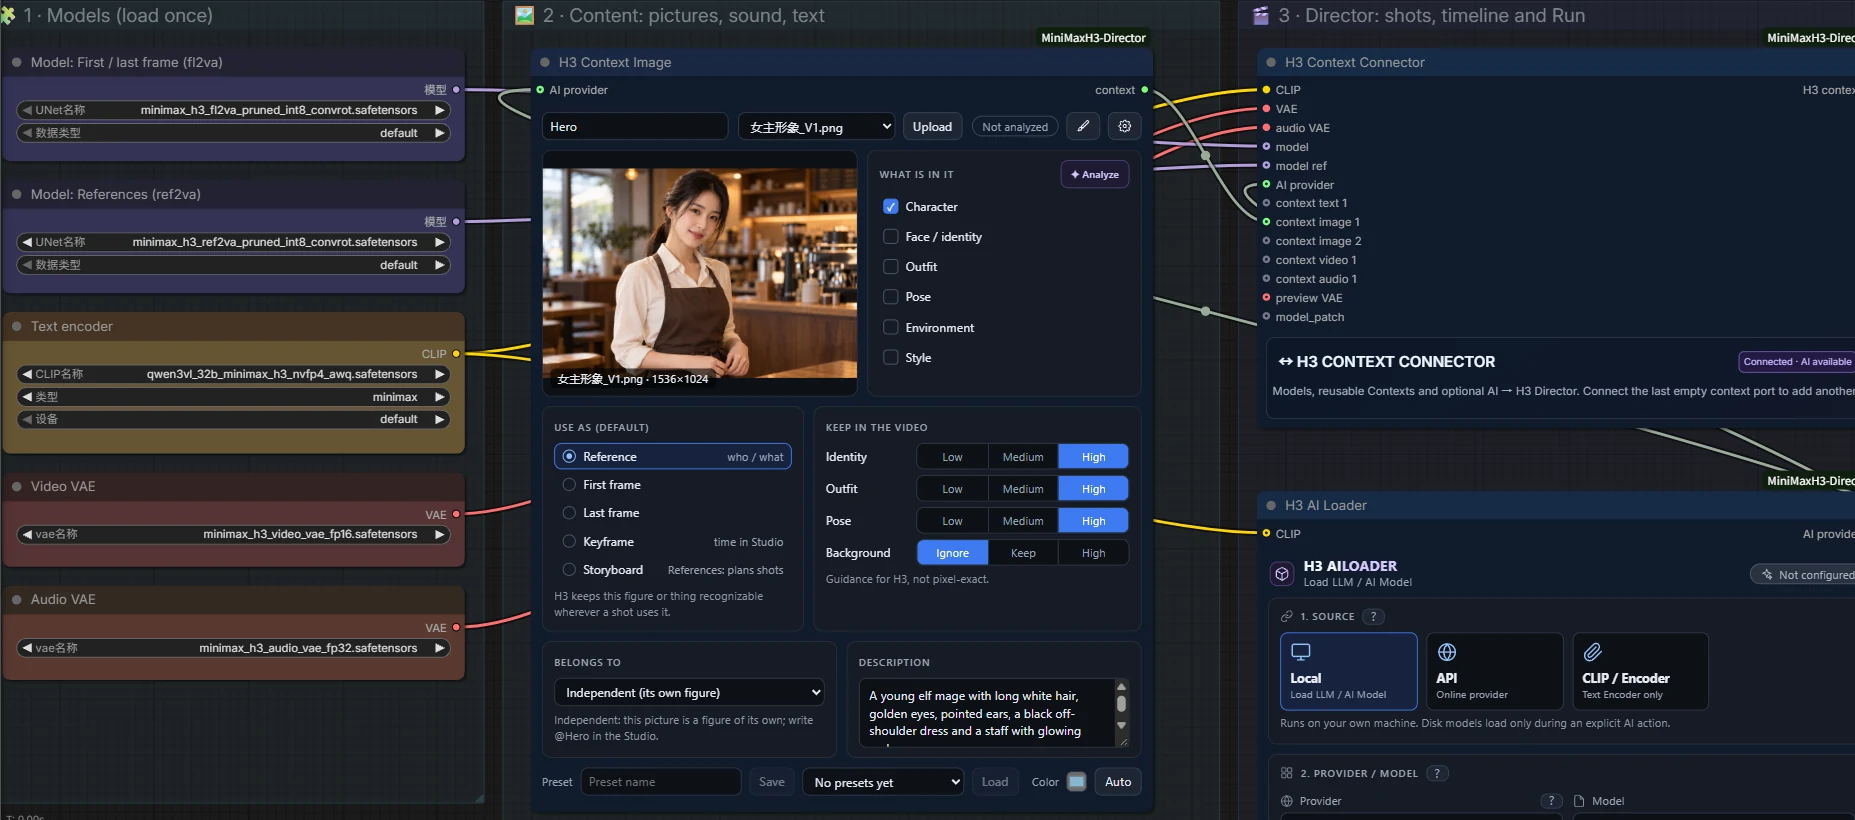
导入示例后,ComfyUI画布上会有一组相连的节点。它们大致分为模型加载、素材和Director三部分。进入Director的 Full screen 后,可以在较大的Studio界面里编辑镜头。
 看原图
第一部分是模型。 主模型、文本编码器、Video VAE、Audio VAE等各有加载节点。示例也会提示缺失文件。文字生成和人物参考使用的H3模型、Turbo LoRA有区别,要按对应工作流选择,不能看到名字里有Turbo就随便替换。
第二部分是素材卡。 图片卡里可以上传人物图、填写名称和描述,再选择用途:Reference是参考,First frame和Last frame分别用于首帧、尾帧。人物参考还可以设置身份、服装、姿势和背景的保留程度。
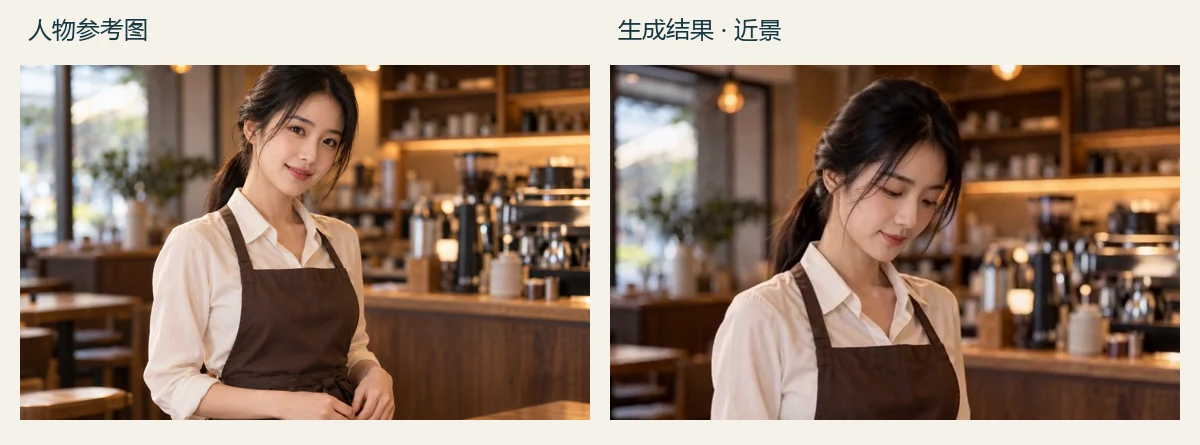
我这次把咖啡师图片命名为 Hero,在镜头文字里用@Hero引用她。身份和服装设High,姿势设Low,让外观保持住,同时留出做动作的空间。
 看原图
换图时还有个小细节:示例原来的描述不会自动变成新人物。我上传了咖啡师图,下方却还留着白发精灵的文字,需要手动一起替换。图片和描述说的是同一个人,后面的镜头才好安排。
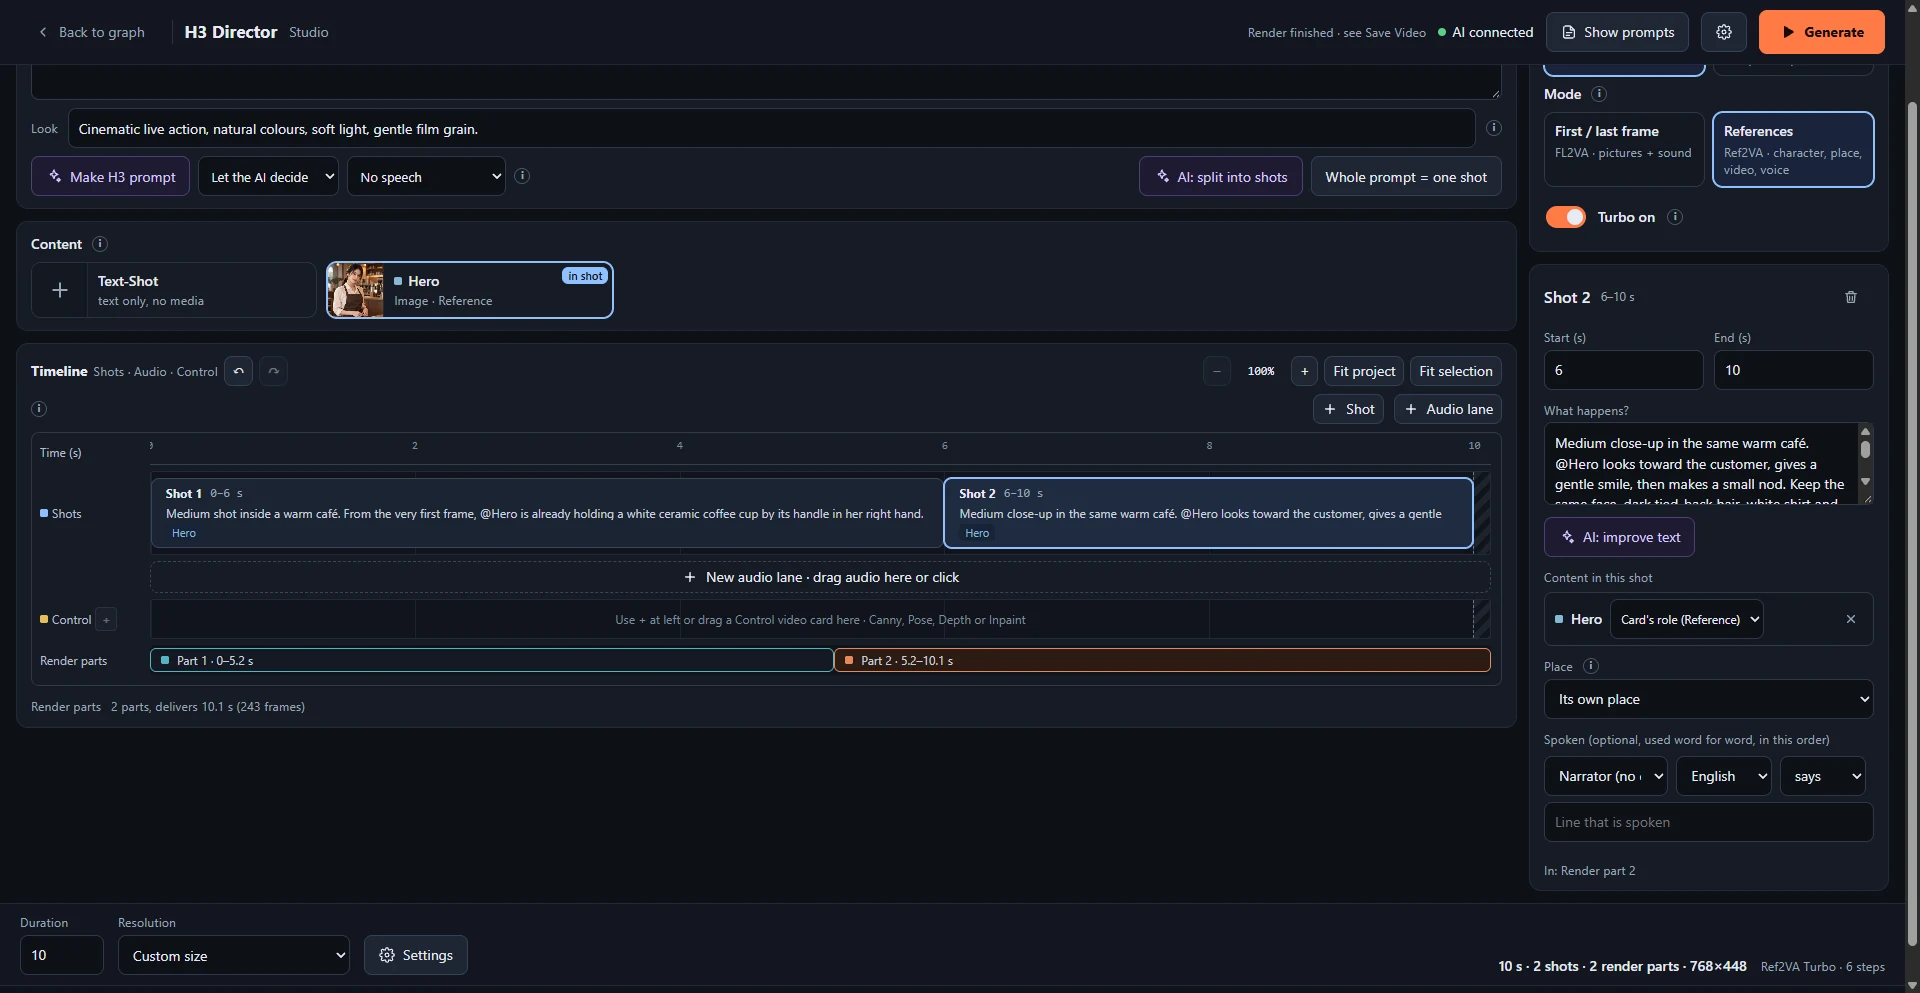
第三部分是Director Studio。 顶部Prompt填写整体想法,Look写视觉风格;右侧选择输出视频还是图片,以及First / last frame或References模式。
中间的时间轴负责安排镜头。点选Shot 1或Shot 2,右侧就会出现 Start、End和What happens?,分别填写开始时间、结束时间和镜头内容。要写对白,则在下面的Spoken区域填写;不需要对白,要把示例已有台词清掉。
 看原图
底部 Duration 是总时长,Settings 里设置分辨率、Seed、采样步数、Turbo、环境声和分段长度。改好以后,先点 Show prompts 看实际编译给模型的内容,再点 Generate 开始生成。
这里尤其要认清两条东西:上方的 Shots是叙事镜头,下方的 Render parts是实际生成任务。两张镜头卡,可能被放进一个渲染分段;一个镜头也可能跨过分段边界。后面能不能复用前段,就与这个范围有关。
界面里的AI辅助可以连接本地模型或API,帮助写描述和分镜。我这次直接填写镜头,没有另外配置这部分。
今天先跑通文字,再换成自己的角色
我建了独立测试实例,保留原环境,通过额外模型路径读取已有H3模型。测试机器是 RTX 5070 12GB、32GB内存,核心固定在ComfyUI 0.37.0对应提交,节点固定为v1.0.0。
安装入口和模型清单在项目仓库里。我采用Git固定标签,放到独立实例的custom_nodes目录;复制来的Python环境已经满足OpenCV要求,没有另行升级Python和Torch。
第一次运行卡在Preview VAE,报VAE is invalid: None。这套核心无法识别下载的taeh3预览权重。移除预览节点还不够,插件内部仍会寻找它;最后我把测试目录里的文件改为.disabled扩展名,重启后绕过实时预览。正式的Video VAE、Audio VAE继续保留,用于最终输出。
跑通后的第一个样片是灯塔:768×448、Turbo 8步,设置5秒,按帧网格对齐后约5.17秒,全流程 93.69秒。画面、运镜和声音正常,再进入人物参考测试。
人物测试从第2个工作流开始。我删除示例声音参考,换成自己的咖啡师图片,安排了两个镜头:前半段放下白色咖啡杯,后半段切近景,抬头看向顾客并微笑。分辨率仍为768×448,Ref2VA Turbo使用6步。
第一版人物保持一致,近景切换也出现了,但开头有个问题:杯子先飞到了她手上,后面的放杯动作反而正常。
我只补了开场状态,明确从第一帧开始,她已经用右手握着杯柄:
From the very first frame, @Hero is already holding a white ceramic coffee cup by its handle in her right hand.
接着再写慢慢放下、杯底落到台面、松开杯柄。杯子不用临时“赶场”,修订版里这段动作就正常了。该版全流程 194.76秒。
这次让我更留意动作的起点:写“她放下杯子”之外,还得说明一开始杯子在哪只手里。这样改动更具体,也更容易对照结果。
改后面的动作,前面可以留下来吗?
我又把10秒视频设为5秒左右一段,并开启Resume、取消“完成后删除保留分段”,让生成缓存留下来。
第一次只改第二镜头,两段却都重算了。因为第二镜头从第5秒开始,第一渲染段到约5.2秒才结束,改动已经进入第一段。
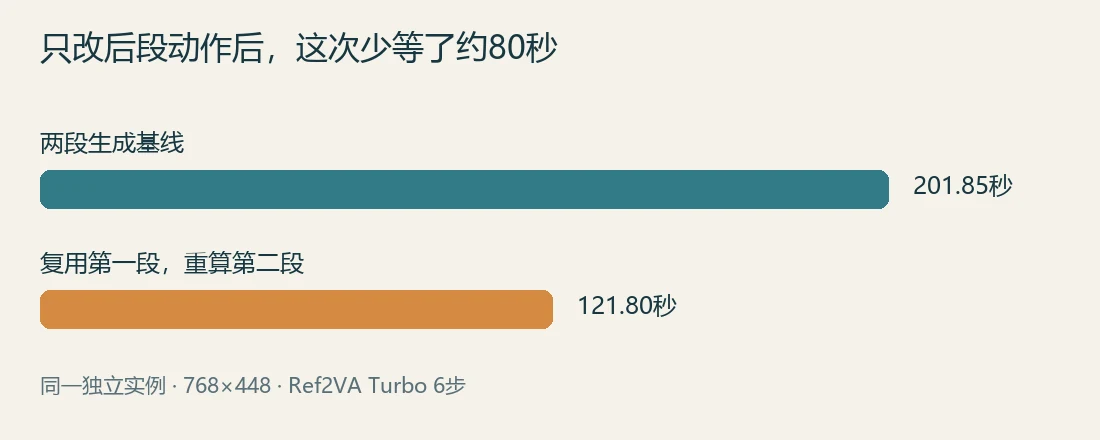
随后我把镜头交界移到第6秒,用Show prompts确认第一段只包含Shot 1,再生成一版基线。保持其他参数不变,只把第二镜头的“轻轻点头”改成“轻轻歪头”。
 看原图
这次歪头动作出现了。记录与缓存对照显示,第一段没有重新写入,只新增了第二段缓存:基线 201.85秒,修改后 121.80秒,本次少等约80秒。
我的理解也更具体了:想留下前面的结果,得看修改有没有影响前面的渲染分段。只看“我改的是第二张镜头卡”,还不够。衔接帧也会影响实际切镜时间,所以这次第6秒交界的配置主要用于测试缓存,精确切镜还要继续调。
另外,双分段的一版在约第9秒出现过不明人声。台词为空,也写了No speech,仍然发生了;后来的点头版没有人声。目前还没找到稳定复现或消除的条件,输出后完整听一遍音轨仍有必要。
这一期,先把两个入口用起来
今天跑下来,第1个工作流让我确认文字生成链路可用,第2个工作流做出了自己角色的双镜头。人物外观、动作修正,以及修改后段时的缓存复用,都有了实际样片。
这期先停在这里。9个工作流里的歌曲、故事板、姿态与深度控制、人物替换,还有声音参考和长视频,篇幅里挤着介绍不如下一期继续动手试。我也想看看,同样这张12GB显卡,换成更复杂的任务还能走多远。
你更想先看声音参考、跟随参考视频做动作,还是视频人物替换?欢迎在评论区交流。
智能搭子 · 和你一起把AI真正用起来 · 真实体验 · 客观判断 · 持续探索
测试环境
耗时是整条工作流的单次记录,不代表通用性能。
- 显卡
- RTX 5070 12GB
- 内存
- 32GB
- ComfyUI 核心
- 0.37.0
- H3 Director
- v1.0.0
- 分辨率
- 768×448 · 24fps
- 双镜头 10 秒
- 约 3 分 15 秒
- 实测日期
- 2026-10-29
来源与使用范围
用到的素材和工具来自不同作者,使用前请看清各自的范围。
可以这样用
H3 Director 节点是 GPL-3.0 开源,可以用、可以改;改过再分发,也要保持开源。
不要这样用
把项目自带的示例人物、故事板等素材单独拿去再分发或商用;没读 MiniMax H3 社区许可协议原文就用于商业项目。
节点:seesee75-commits/ComfyUI-MiniMaxH3-Director(v1.0.0);模型:Comfy-Org/MiniMax-H3。
写在最后
文中的结果都是我在自己电脑上实测的,换一台电脑、换个软件或模型版本,结果可能不一样。
模型和工具的版权归原作者,本站只链接官方下载地址;可下载的工作流和脚本按现状分享,运行前请先看一遍内容,重要文件先备份。
声音克隆、换脸换装、AI 生成的图片、视频和音乐,请只用你自己的或已经获得授权的素材,发布和使用时遵守法律法规和平台规则。
如有内容涉及侵权,请通过公众号「智能搭子」私信联系我,核实后会及时删除。