 智能搭子
【接上一期】我把H3 Director的4个工作流跑了一遍:图片和音乐该怎么用?
大家好,我是你的智能搭子阿洁。
接着上一期的H3 Director实测,我们继续往下做。上期介绍了这个项目和它的9个工作流,先测了文字生成视频、人物参考两个入口。
这次我给人物配了一段歌、让三张图片分别动起来、把同一个人物放到不同场景,再把两格故事板变成视频。其中有一个入口,点完生成,得到的其实是图片。
四个入口都有了输出,但用法差别很大。同样一张人物图,拿来告诉模型“她是谁”,和要求视频“从这张图开始”,是两回事。 这也是这篇最想讲清楚的地方。
这轮我选好音乐后,让Codex接手操作并逐步截图,继续用本地RTX 5070的12GB显卡测试。先把短样片跑通,再看哪些做法适合接着用。
01 有现成歌曲,先试第3个音乐视频
音乐视频这项,我用了示例里的白发精灵人物,加上一段约21.6秒的《荒》音乐片段。
目标很具体:让画面里的人物演唱这段歌,音乐沿用上传的文件。 这和只在生成视频后面铺一条背景音乐,要求不一样。
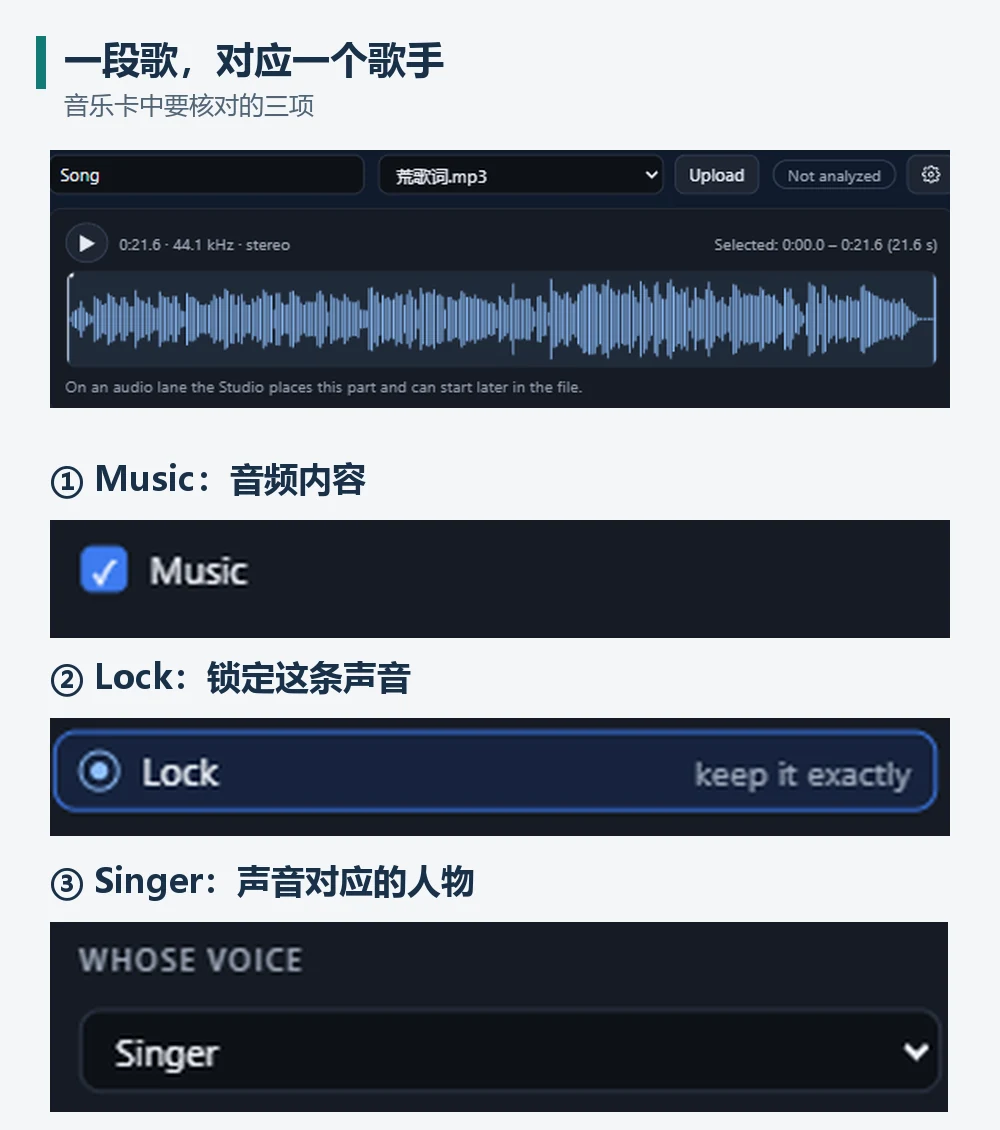
人物图片卡选Reference,也就是人物参考;音乐放进Audio卡,关键是这三项:
- Music:说明音频里是什么。
- Lock:让这条音频作为锁定的声音使用。
- Whose voice → Singer:把声音对应到画面里的歌手。
 看原图
这里我会特别留意时长。换过音频后,要核对波形上显示的片段长度,以及Director底部的Duration;我这次把项目时长设成21.6秒,没有直接沿用示例原来的30秒。
分镜则尽量让脸和嘴可见:正面中近景、略带侧面的中近景、正面近景,每段7.2秒。背影再好看,也不能拿来检查有没有在唱。
这次用了768×448、Ref2VA Turbo 6步,按约5秒一段渲染,生成用时约7分24秒。最终视频约21.46秒。
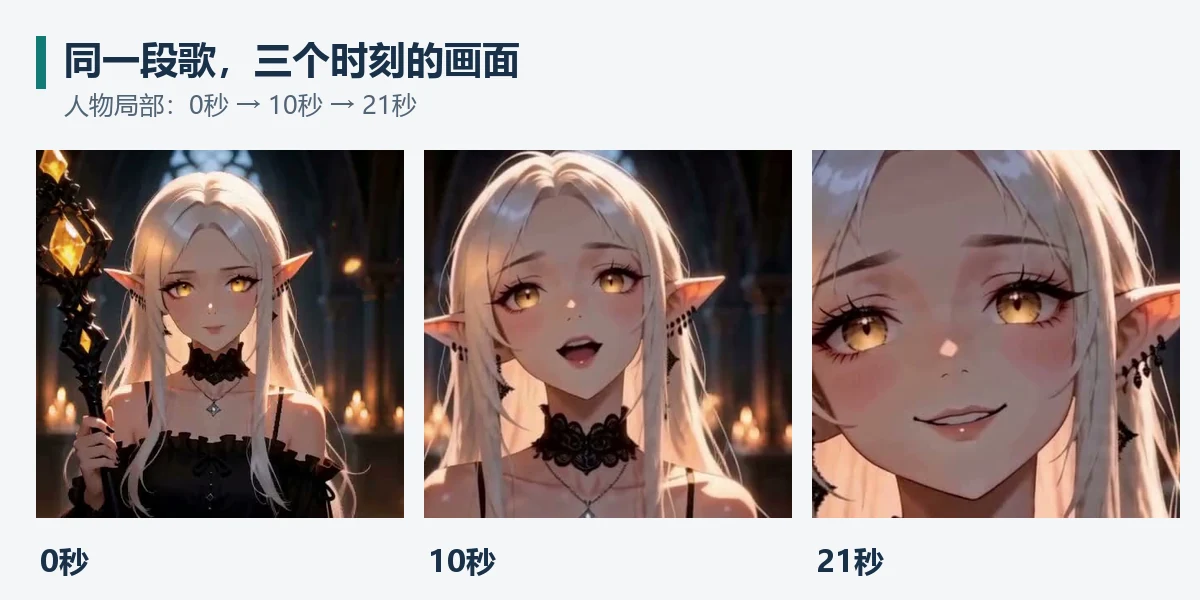 看原图
抽帧里,白发、黑色服装和人物主体保持住了,嘴部有变化。不过,计划里的三种景别没有变成三个很明显的切镜,成片更像连续靠近人物。
音轨比对显示,输出音乐与原片段高度一致、没有测出整体时间偏移,但结尾少了约0.13秒。画面有没有逐句唱准,还需要结合原片听看;仅凭张嘴的截图,判断不了精确对口型。
如果想尝试给自己的歌曲做人物演唱画面,这个入口值得先做短片段测试。先检查声音和嘴,再考虑把整首歌交给它,能少等不少时间。
02 三张图分别做开场,要用第4个工作流
第4个“Shots from pictures”,最容易和人物参考混在一起。
人物参考的意思是:“记住这个人的样子,帮我拍一段新画面。”
这里的图片则是:“这个镜头就从这张画面开始,再往后演。”因此,图片卡要选First frame(首帧),Director使用First / last frame模式。
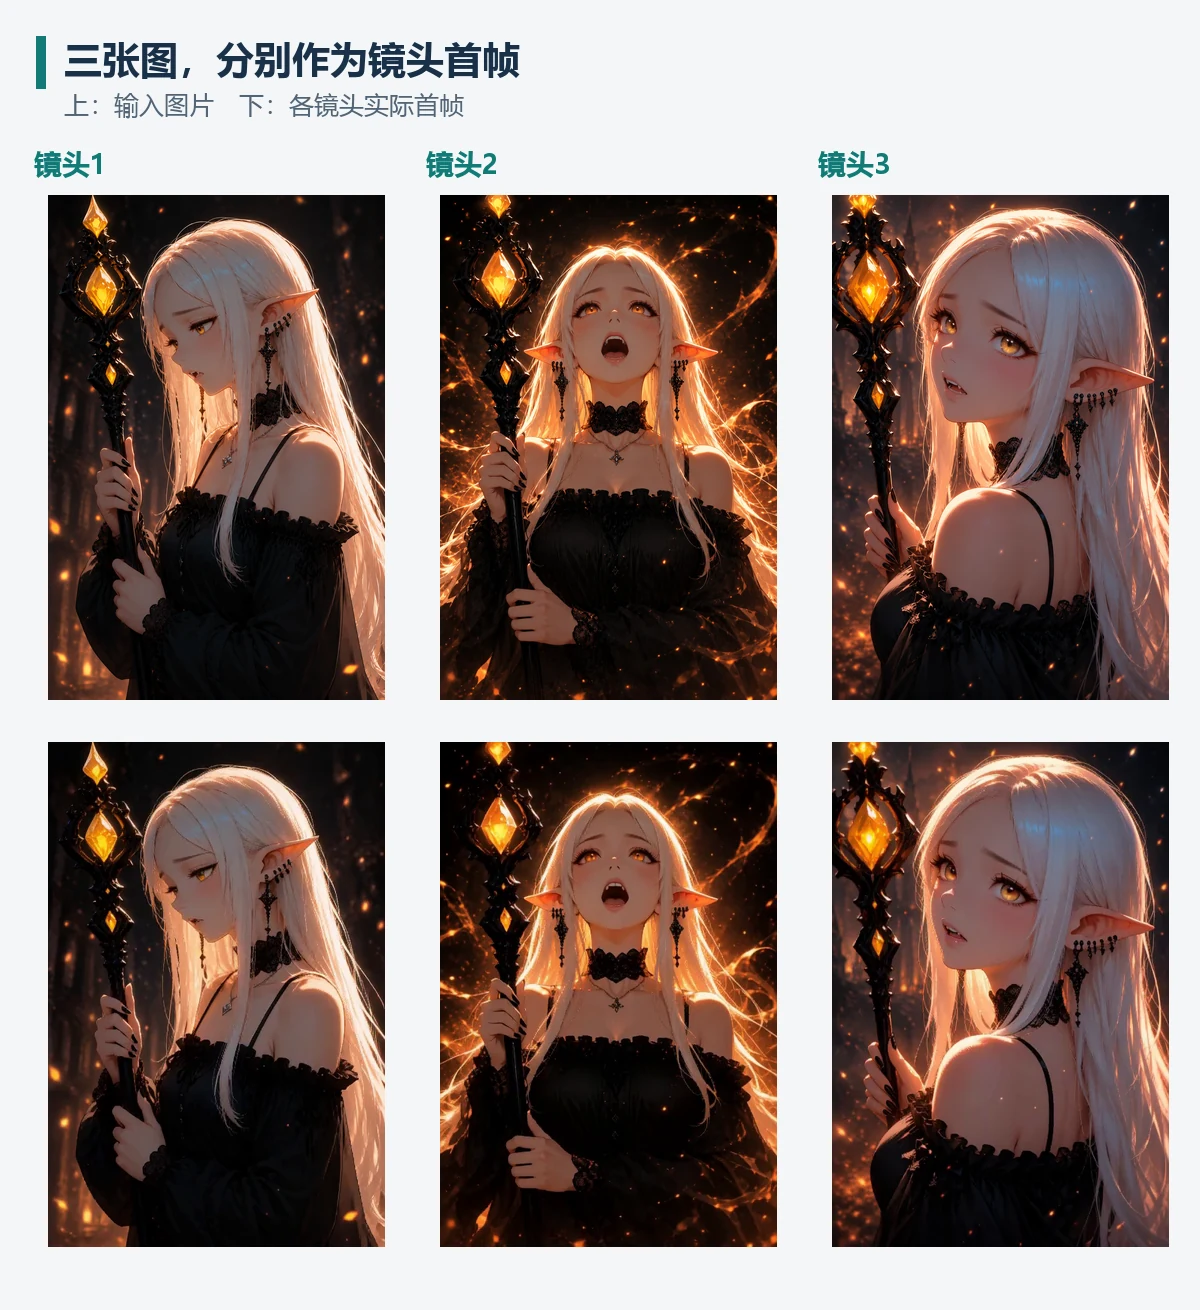
我这次放了同一个人物的侧面、正面和背侧面三张图,每个镜头约5秒。提示词写的是从图中状态往后发生的动作和运镜。
这三张原图都是竖构图,所以视频也保持竖版,设成448×672,并选了Pad适配。把竖图直接塞进横版再用Crop居中裁切,头顶和身体就可能被裁掉;先统一比例,比生成后再救构图省事。
 看原图
图里上排是输入,下排是各镜头实际首帧。三个视角都对应上了;原图经过视频编码后,颜色和细节有轻微差异。
这条视频用了FL2VA Turbo 8步,生成约5分15秒,实际长度约14.79秒。计划写15秒,文件不一定正好15秒,H3会按自身的帧数规则生成。
这项适合已经挑好开场画面的情况,比如人物出场、产品展示、分镜首帧。我想让镜头从哪一张画面起步,就把那张图绑定到对应镜头。 图片之后怎么动,仍要靠提示词和成片一起检查。
03 第5个入口先出图,给视频准备素材
接下来这个“Pictures”,名字很直白:每个镜头生成一张静态图片。
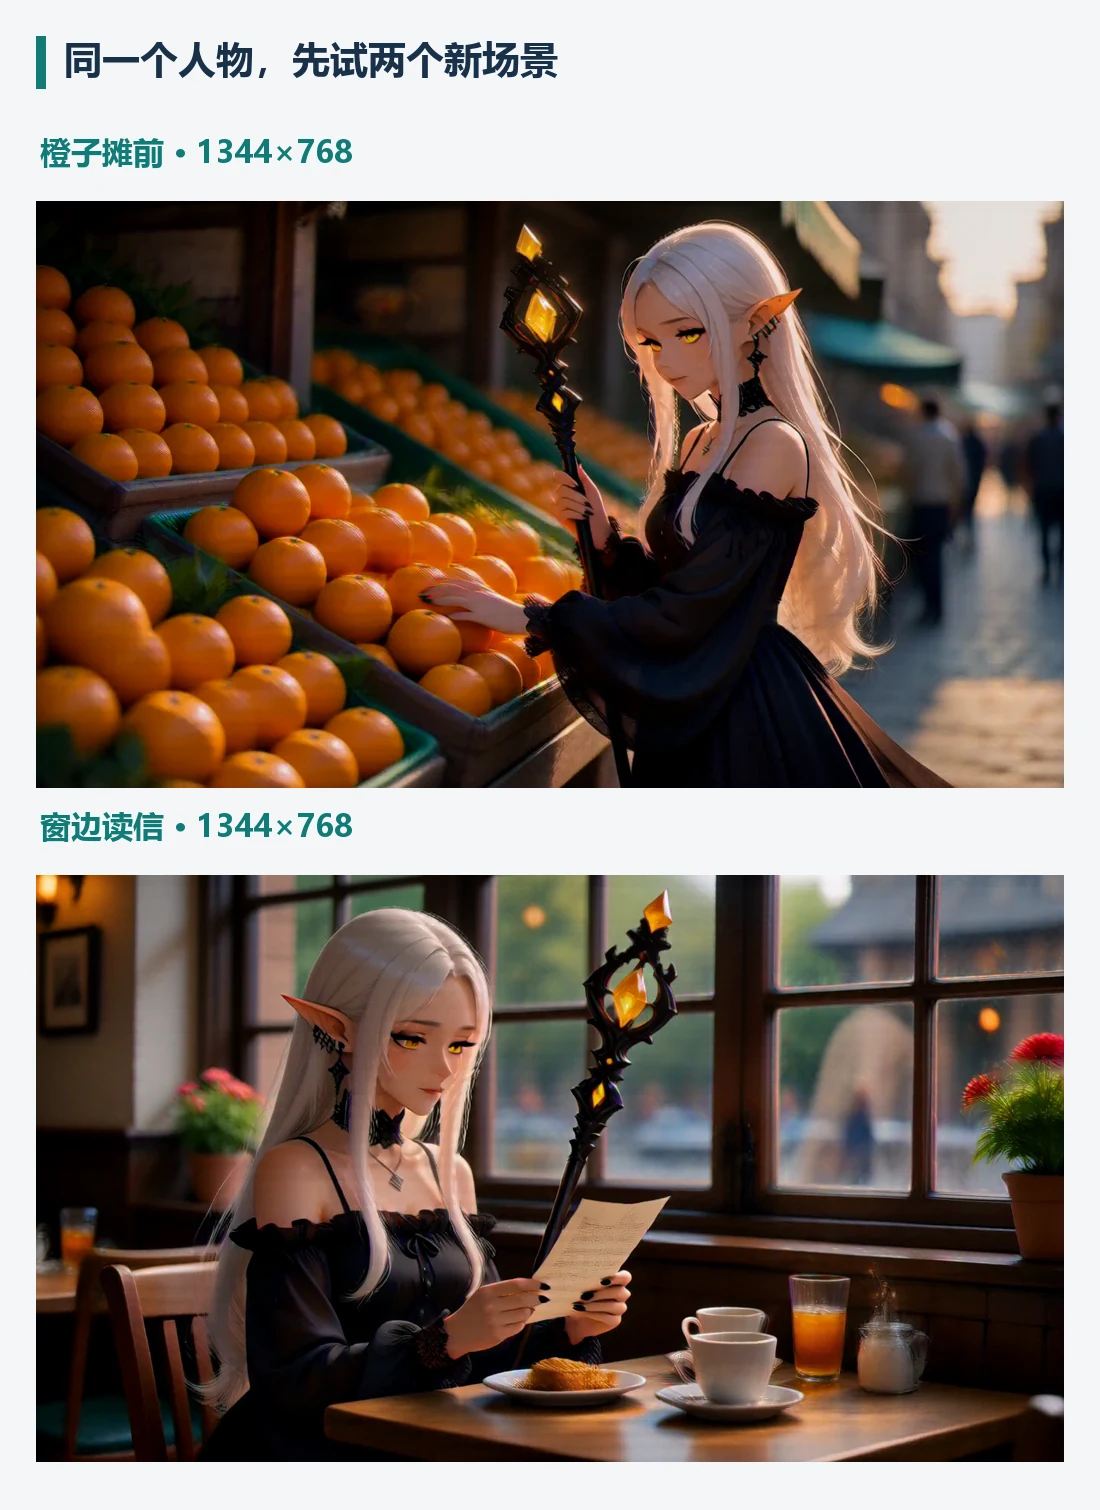
我仍然用了白发精灵人物,把输出切到Pictures,只写两个场景:一个在橙子摊前,一个在咖啡馆窗边读信。人物卡作为Reference,负责提供外观参考。
最初我用768×448做了一轮短测,后来把出图分辨率提高到1344×768,沿用同一个人物、两个场景和随机种子重新生成。下面放的是提高分辨率后的结果,这两张合计生成约1分2秒。
白发、尖耳、黑色服装和法杖这些主要特征保留了,图里能看到橙子表面、信纸和杯碟的细节。这次是重新生成,人物位置和构图也有变化。
 看原图
它在创作流程里的位置就清楚了:还没挑好画面时,可以先出静态图,再决定哪张值得做成视频。
图片会保存到output/H3,也会进入input/h3-director-stills,方便在图片卡里继续选择。如果要接第4个工作流,可以把选中的图设成镜头首帧。这次我分别验证了出图和图片转镜头,还没有把这两张新图接着生成视频。
挑图时,我还会检查手部、道具和局部细节。人物一眼认得出来,还不够决定这张图能否继续用。
04 先排故事板,再生成双人镜头
第6个“Storyboard”,我用了项目自带的两个人物和大厅场景,缩成两格、每格5秒的小测试。
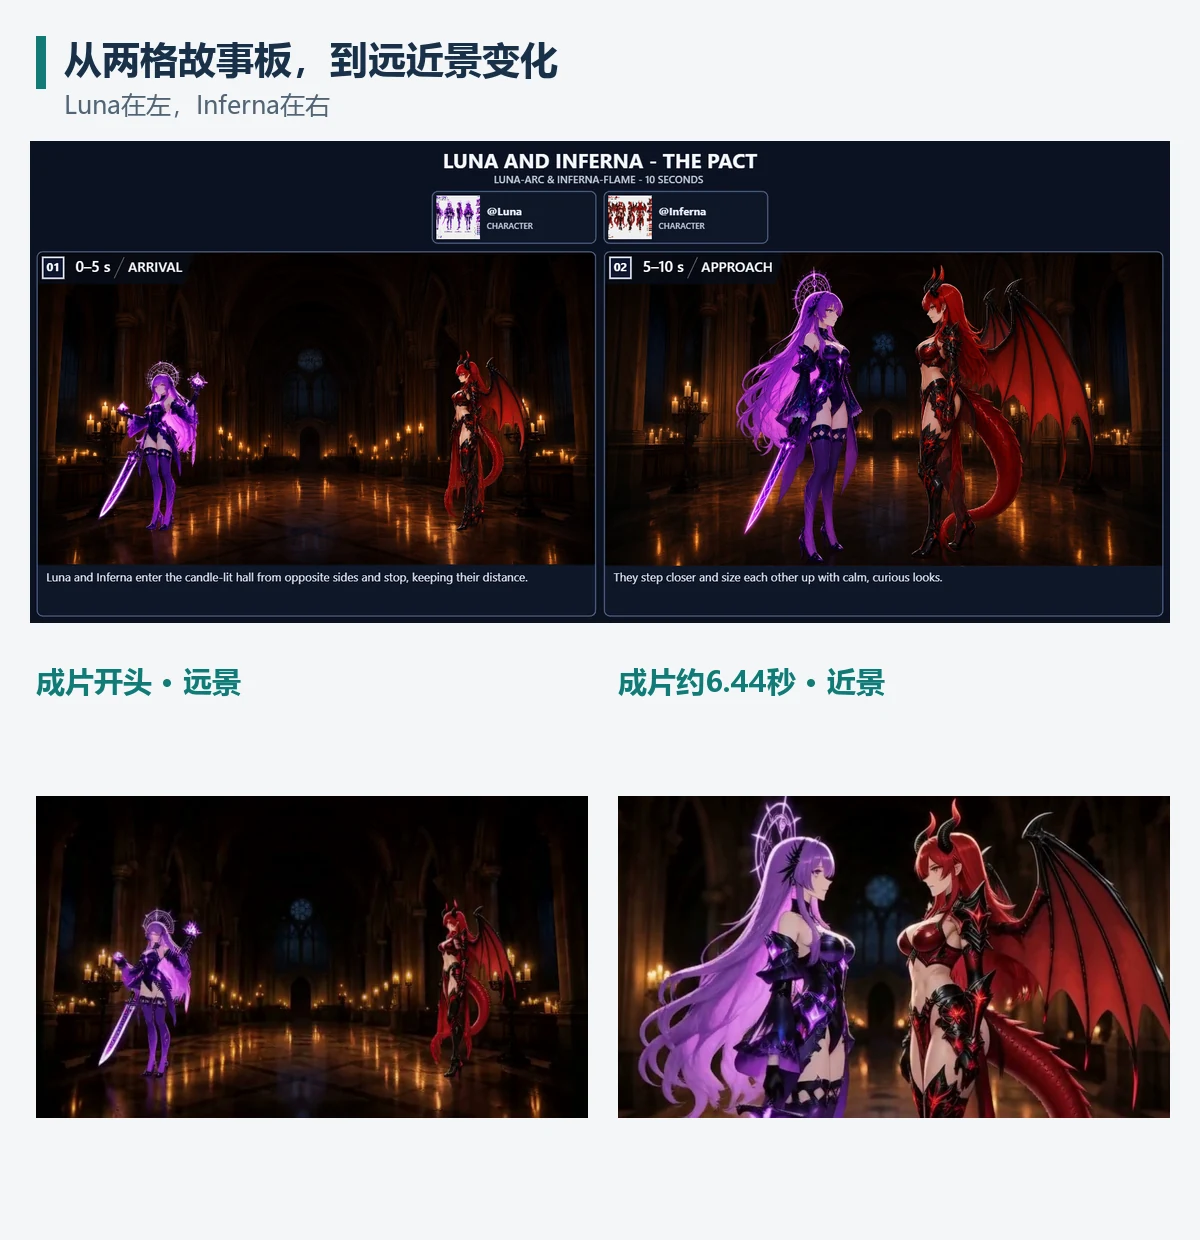
第一格是远景:紫发的Luna在左,红发的Inferna在右,两人隔着大厅相对而立。
第二格靠近一些:两人走近,面对面看着对方。
 看原图
故事板节点里,图片、每格时长和镜头文字都可以一起安排。画面先摆出来,人物站哪边、下一格看什么,就比只在一长段文字里交代更直观。
故事板和首尾帧,区别在哪里?
看着这两格图,确实容易联想到首尾帧,但两者交给模型的任务不同。
首尾帧是在安排一个镜头的两端。 首帧图告诉模型从哪张画面起步,尾帧图给出希望收束到的画面,中间生成过渡。如果只有首帧,就是前面第4项的用法:从指定图片开始,再按提示词往后动。
故事板是在安排一组镜头。 每一格可以有自己的时长、构图、人物站位和动作描述,先把“先拍什么、接着拍什么”摆清楚。它也能放很多格,不只是一头一尾两张图。
这次的两格分别对应两个镜头,使用的是Storyboard参考;没有把面板勾选为镜头首帧或尾帧。因此,这两格图不是整条10秒视频被固定下来的起点、终点,生成时的景别和切换时刻仍可能变化。
两种做法也可以配合。故事板面板上还有“First frame of its shot”和“Last frame of its shot”,可以把某一格同时指定为对应镜头的首帧或尾帧,再送进Director。本轮先测故事板参考,尚未展开这种组合。
这两个按钮要分清:
- Use in Director:把画好的整张故事板变成素材卡。
- Send to Director:把各格的时长和描述送成时间轴上的镜头。
 看原图
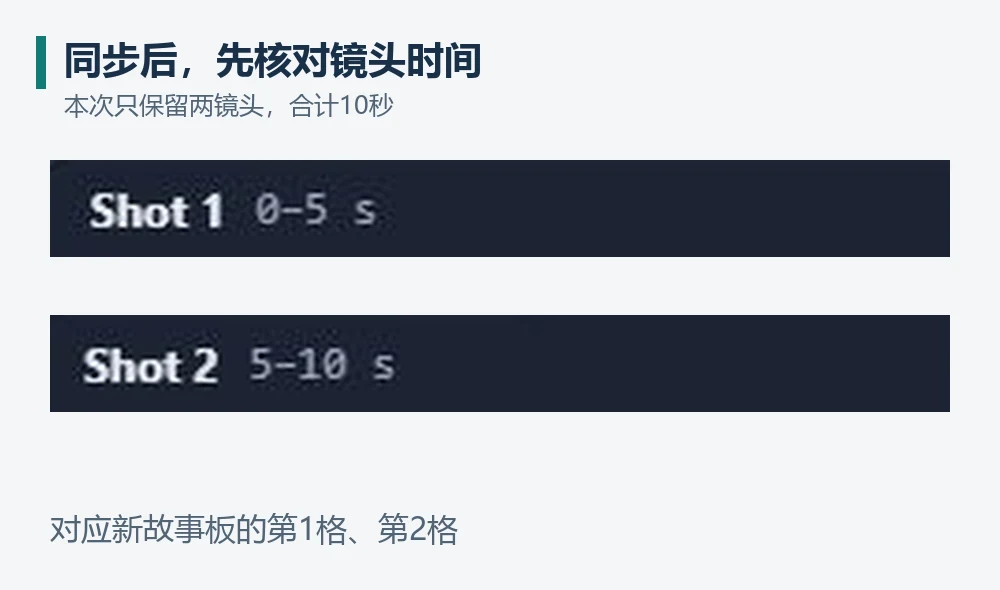
我这次同步后,新镜头追加在原示例镜头后面。最后清掉测试副本里的两个旧镜头,只保留新来的两格,并把时间改成0—5秒、5—10秒。同步后先看一眼镜头总数和总时长,别让旧镜头一起混进生成任务。
中间还遇到一个Windows路径问题:故事板图片已经生成了,提交时却提示图片输入不可用。前端用了正斜杠子目录路径,后端枚举的是反斜杠;这次保留原文件,另外复制一份到input根目录,再在测试副本里重新引用,才通过校验。
最终这条768×448视频约10.13秒,生成用时约4分15秒。抽帧能看到两个人物保持左右位置,画面也从远到近,逐渐变成面对面的近景;景别变化没有严格卡在写下的5秒位置。
这轮复用了示例已有的面板图,测试的是“故事板转镜头,再生成视频”。Qwen重绘面板和自动抠图等做法,这次没有展开。
手里有什么素材,就从对应入口开始
跑完这四项,我会这样选:
- 有歌曲,想做人物演唱画面:第3个,先把音频Lock和人物对应关系设好。
- 有已经选好的开场图:第4个,每张图绑定一个镜头首帧。
- 还缺场景图、人物画面:第5个,先生成静态图片挑选。
- 已经想好镜头顺序和人物站位:第6个,先排故事板再送进Director。
想跟着试,可以在已装好H3模型的ComfyUI里打开Templates,搜索H3 Director,按上述英文名称找对应示例。我本次用的是seesee75-commits维护的v1.0.0,项目入口见H3 Director仓库。
12GB显卡这轮跑通的是短样片:音乐和故事板用了768×448,静态出图提高到1344×768,三张图转镜头用了448×672。每项的素材和设置不同,上面的用时可以参考,不适合拿来当工作流速度排名。
我会先拿这些短结果挑出能继续用的画面。
考虑到篇幅,这期先测第3到第6个,共四个工作流;剩下的第7到第9个——动作控制、人物替换和自定义采样,留到下一期测完。
智能搭子 · 和你一起把AI真正用起来 · 真实体验 · 客观判断 · 持续探索
测试环境
每项素材和设置不同,用时只作参考,不当作工作流速度排名。
- 显卡
- RTX 5070 12GB
- ComfyUI 核心
- 0.37.0
- H3 Director
- v1.0.0
- 音乐视频 21 秒
- 约 7 分 24 秒
- 三图转镜头 15 秒
- 约 5 分 15 秒
- 故事板 10 秒
- 约 4 分 15 秒
- 实测日期
- 2026-10-30
来源与使用范围
用到的素材和工具来自不同作者,使用前请看清各自的范围。
可以这样用
H3 Director 节点是 GPL-3.0 开源,可以用、可以改;改过再分发,也要保持开源。
不要这样用
把项目自带的示例人物、故事板等素材单独拿去再分发或商用;没读 MiniMax H3 社区许可协议原文就用于商业项目。
节点:seesee75-commits/ComfyUI-MiniMaxH3-Director(v1.0.0);模型:Comfy-Org/MiniMax-H3。
写在最后
文中的结果都是我在自己电脑上实测的,换一台电脑、换个软件或模型版本,结果可能不一样。
模型和工具的版权归原作者,本站只链接官方下载地址;可下载的工作流和脚本按现状分享,运行前请先看一遍内容,重要文件先备份。
声音克隆、换脸换装、AI 生成的图片、视频和音乐,请只用你自己的或已经获得授权的素材,发布和使用时遵守法律法规和平台规则。
如有内容涉及侵权,请通过公众号「智能搭子」私信联系我,核实后会及时删除。