 智能搭子
【接上一期】H3 Director最后3个工作流:借动作、换人物,效果如何?
大家好,我是你的智能搭子阿洁。
接着上期的H3 Director实测,这次把剩下三个工作流补上:动作控制、人物替换、自定义采样。
第一次看到这个项目,可以先这样理解:H3 Director是装在ComfyUI里的视频编排工具。 我把人物图片、声音或参考视频放进素材卡,在时间轴上安排镜头,再由MiniMax H3生成视频。它自带9个示例工作流,每个示例给出一种素材组织和生成方式。
前两项看起来很像:都有一张人物图、一段视频,最后都想让指定角色动起来。但真正跑过一轮,会发现它们回答的是两个问题:是借用视频里的动作,重新生成画面,还是把原片里的人换掉?
这次,白发精灵确实转过身,也进入了原视频的石厅。不过,人物替换中间先交出了两版大黑块;修复后能看见人了,转身的时间又没完全跟上原片。下面把这些结果一起放出来。
这轮继续用RTX 5070的12GB显卡,由Codex接手独立测试环境的操作、截图和排查。我先做约10秒短片,7、8两项都保持448×672竖版、Ref2VA Turbo 6步,按约5秒分段生成。
先找到示例,再准备对应素材
如果已经能在ComfyUI里运行MiniMax H3,接下来按H3 Director项目仓库说明安装节点包和依赖,重启ComfyUI,在Templates(模板)里搜索H3 Director,就能按英文名称找到这三个示例。我用的是seesee75-commits维护的v1.0.0。
还没有装好ComfyUI和H3基础模型,需要先完成仓库里的安装与模型准备;下面的操作从打开示例开始。
第7、8项还共用一个ControlNet Union 2.0模型,它负责把动作或遮罩这类控制信息送进生成过程。文件放在models/model_patches,由工作流的模型补丁加载节点连接到Context Connector(上下文连接器)。
这轮先用项目自带的人物图、动作视频、姿态片和遮罩,便于把流程跑清楚。换成自己的素材时,最需要分清下面两种准备方式。
01 第7个工作流:借动作,让自己的角色来演
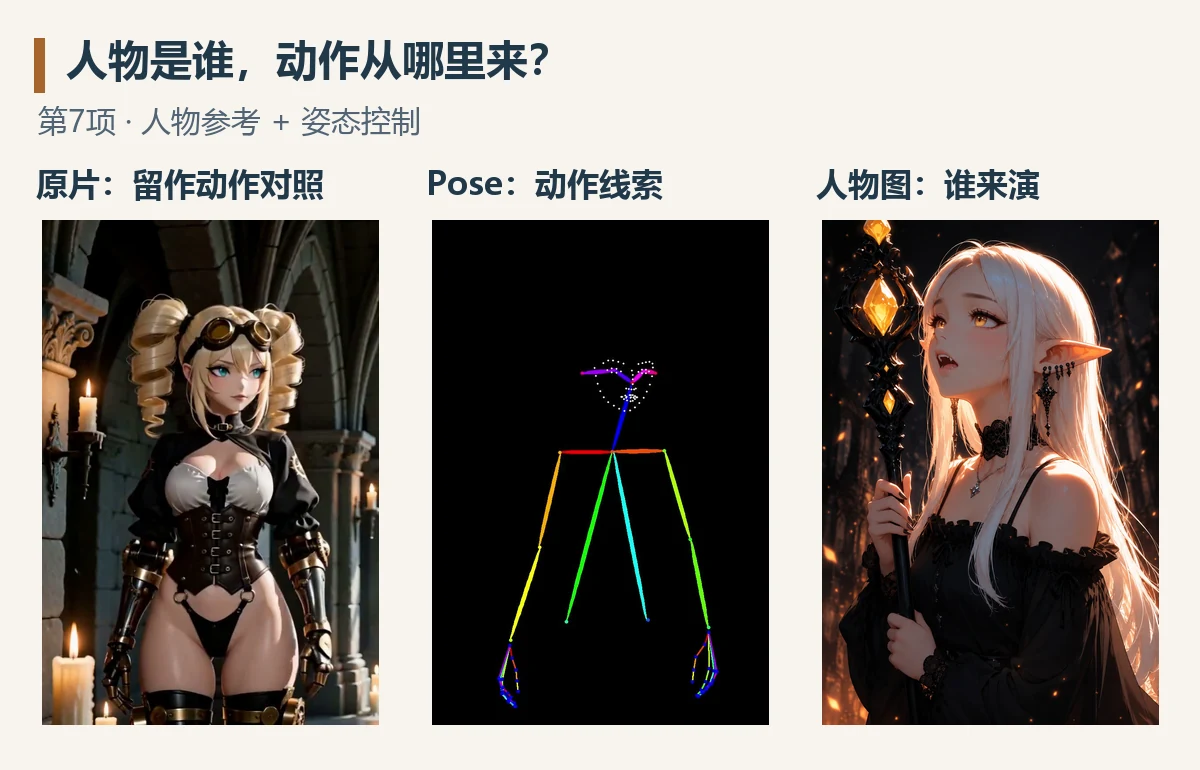
我用了项目自带的三份素材:一段人物转身、靠近镜头的视频;对应的姿态骨架视频;一张白发精灵人物图。
它们各有任务。人物图负责“谁来演”,姿态视频负责提供身体结构和运动线索。原片则留着做对照,检查模型有没有跟上。
姿态片就是把动作逐帧画成彩色骨架的视频。 换用自己的动作片,要先提取姿态,再检查转身、遮挡时有没有漏掉身体关键点。本轮使用示例附带的现成姿态片。
 看原图
在第7个“Control video”示例里,人物图片卡选Reference(人物参考),视频卡选Control video → Pose(姿态控制),并把这条控制片放到Director的Control轨道上,也就是时间轴里放置控制素材的位置。
这一步有个容易漏看的地方:选了Pose,不代表实际读到的就是姿态视频。
前两次排查时,界面虽然显示Pose,实际提交的文件仍是普通彩色视频。后来明确把文件改成h3-example-walk-pose.mp4,再提交,才是下面这版纯姿态测试。
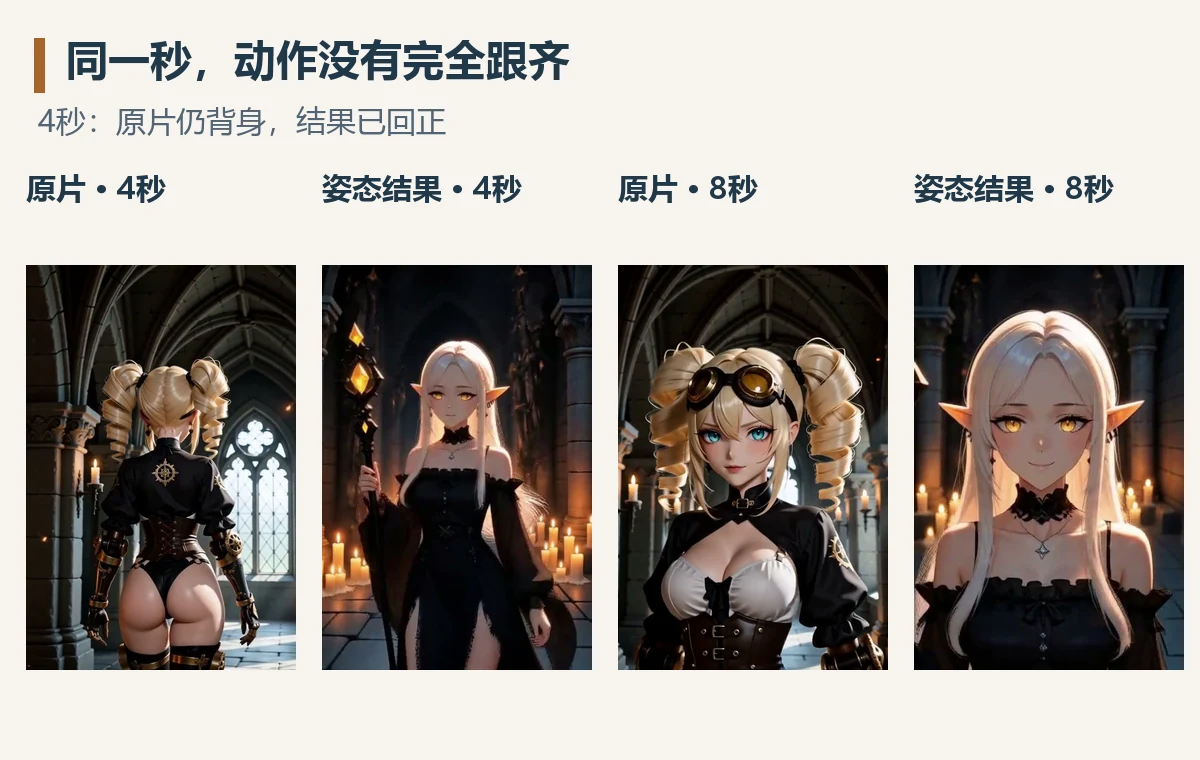
这条片约3分53秒生成,实际长度10.125秒。顺序抽帧里,白发、尖耳、黑裙和法杖都在,人物也完成了转身、回正、靠近这一串变化。
但把同一秒的画面摆在一起,差别就明显了:原片4秒还在背身,生成结果已经转回正面。 到后面,两边都逐渐靠近镜头,变化方向相近,节奏却不一致。
 看原图
再看输入骨架,侧身和背身时有一些头部、躯干关键点缺失。控制素材本身也不完整,因此我会先检查骨架,再决定是否值得重算视频;这一版还不足以说明时点偏差只由哪一个环节造成。
如果只想让角色借用一段转身、走近的大体动作,这个方向可以继续试。要卡音乐节拍、复刻舞蹈动作,就得把原片和结果同步看,单独看一条生成视频,很容易把“动起来了”当成“跟准了”。
02 第8个工作流:圈出原片区域,再把人物换进去
第8个“Inpaint”多了一份关键素材:遮罩。
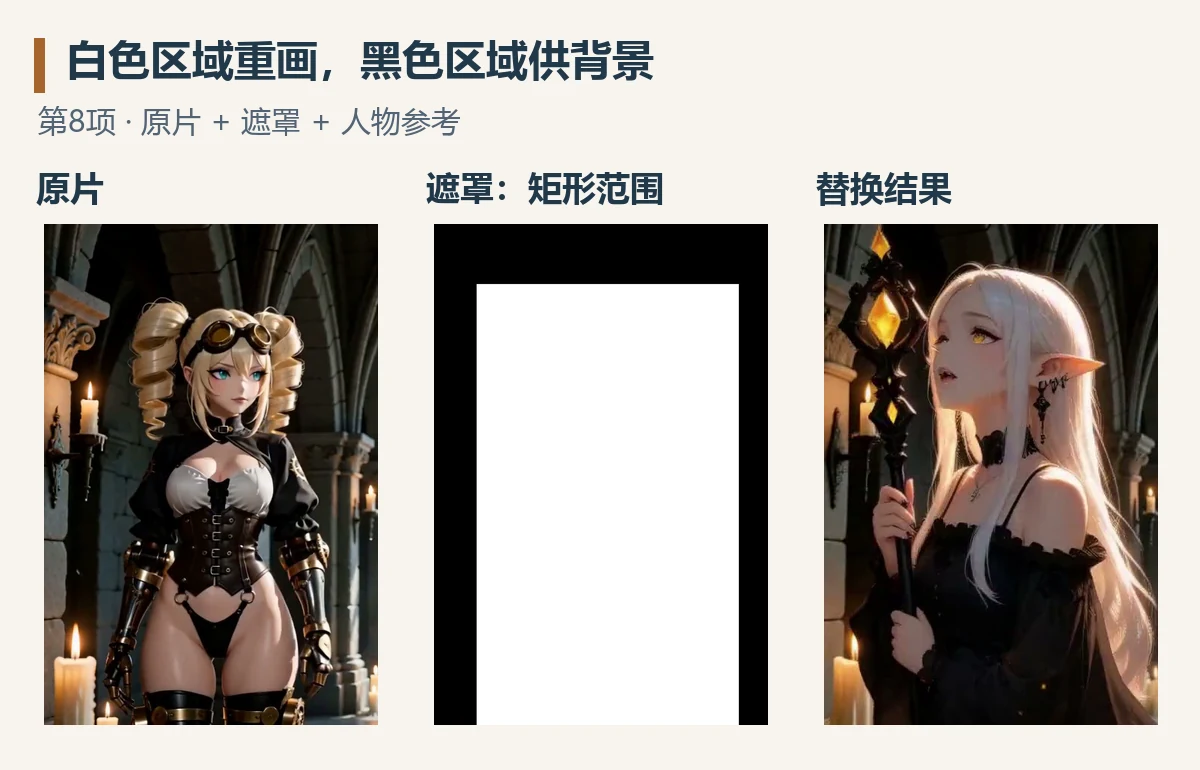
原视频提供场景,人物图提供替换对象,遮罩圈出要重新生成的区域。白色区域重画,黑色区域作为保留背景的输入。
这里的遮罩也是一段视频,要随原片里的人物逐帧变化。换自己的片子,可以用项目里的Generate mask(SAM3)生成遮罩,需要另备对应模型;也可以直接选已经做好的遮罩文件。这次我用的是示例附带文件。
这次仍用同一段原片和白发精灵,另加项目自带的遮罩视频。视频卡选择Inpaint(mask + source),主文件放原片,Mask video选择遮罩;两条素材从同一时刻开始。遮罩形状用Bounding box,向外扩16像素。
 看原图
矩形遮罩给新人物留出了空间,也会把人物周围一部分背景一起交给模型重画。它并不是沿着头发丝精细抠出来的轮廓。
先出来的不是新人物,是一大块黑色
第一版强度设为1,生成约4分5秒,遮罩区域几乎整块发黑。第二版把强度降到0.6,又等了约4分13秒,部分时刻能看见人物,但黑块还在。
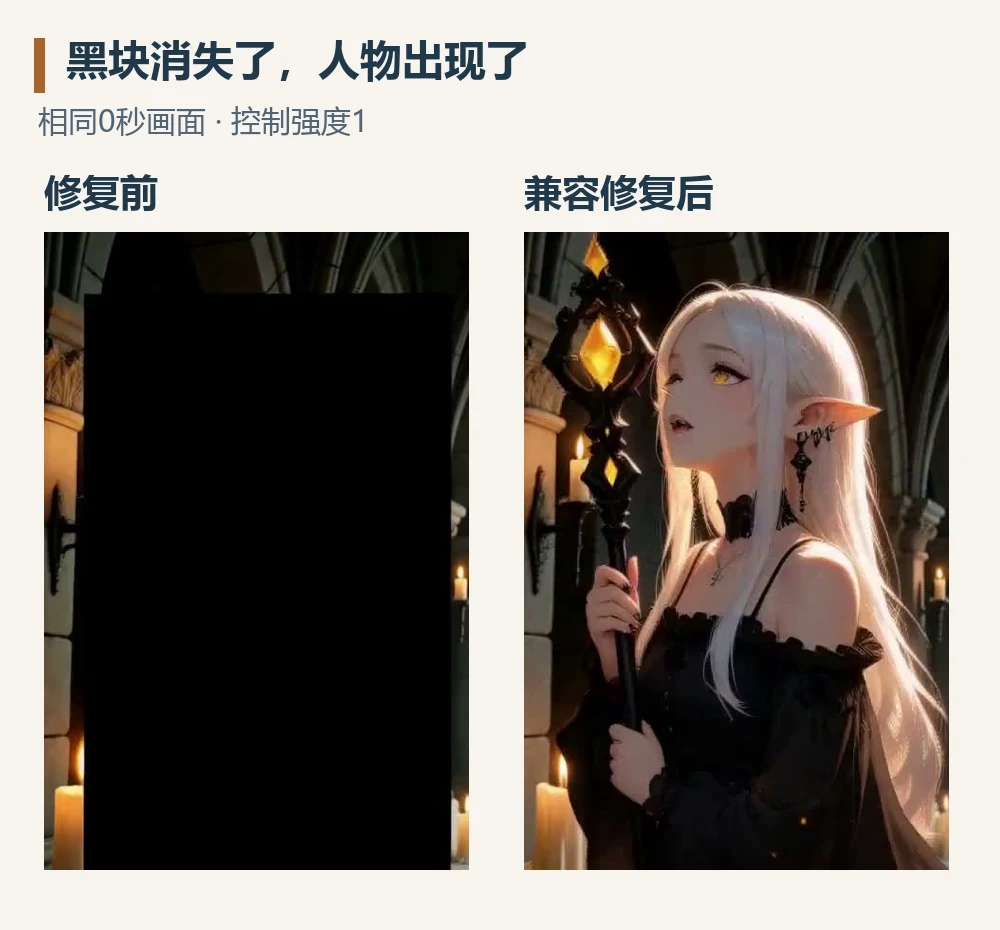 看原图
降低强度没有解决问题,后续排查转向了模型与本地核心的兼容性。
这次补充下载的ControlNet Union 2.0文件约4.53GB,文件校验正常。它的模型说明要求使用post_norm方式处理遮罩:先做像素标准化,再把待重画区域置零。本地ComfyUI 0.37.0这处代码仍在标准化之前填黑,两者处理顺序不同。
不用记住公式,关键是:同样写着“把这块清空”,送进模型的数值可能并不一样。 遮罩区域连续两次发黑后,先核对这一步的兼容处理,比继续修改人物描述更有针对性。
我确认后,只在独立测试实例里做了单文件兼容修复,保留原文件备份,再手动重启。复测沿用第一版的提示词、种子、强度和画幅,只关闭缓存复用,避免把旧黑块接着拿来用。
新一版约4分17秒生成,实际10.125秒。抽帧里,矩形黑块消失了,白发精灵带着黑裙和法杖出现在原石厅中,拱顶、窗户和烛光仍然能认出来。
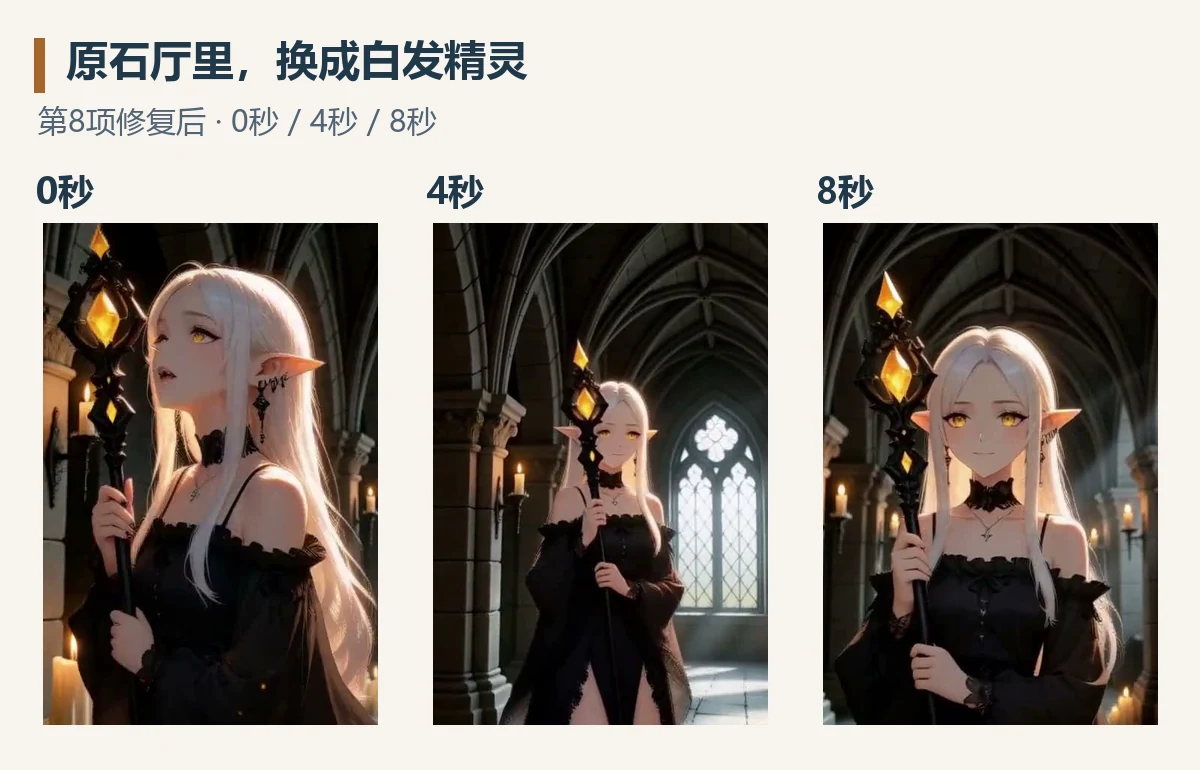 看原图
不过,原片4秒时人物还背对镜头,新角色已经回正,动作时间仍然没有对齐。片尾的遮罩还接近覆盖整张画面,这时模型有很大的重画空间,背景细节也要跟着检查。
这版解决了大黑块,也做出了人物替换;离“原片动作、背景都原样保留,只换一个人”,还有距离。
如果遇到相似黑块,先核对模型版本、遮罩和实际送入的文件,再查对应版本的兼容说明。我这次的修改只在这套测试环境验证过一次,不建议直接拿去覆盖日常使用的ComfyUI。
03 第9个工作流:把采样过程展开,留给需要改节点的人
第9个“Custom sampling”,和前两个不太一样。它不增加一种新素材,主要改变的是生成过程怎么交给ComfyUI执行。
“采样”可以简单理解为模型逐步生成画面的计算过程。平时我填写镜头要求、点击生成,这部分由工作流内部处理;想自己调整这段计算流程,才需要把采样节点展开。
前面的示例用H3 Render Sequence统一处理各段;第9项把循环和采样节点展开。Director仍负责镜头计划,每一段再进入采样循环,最后解码、去掉重叠部分并拼起来。
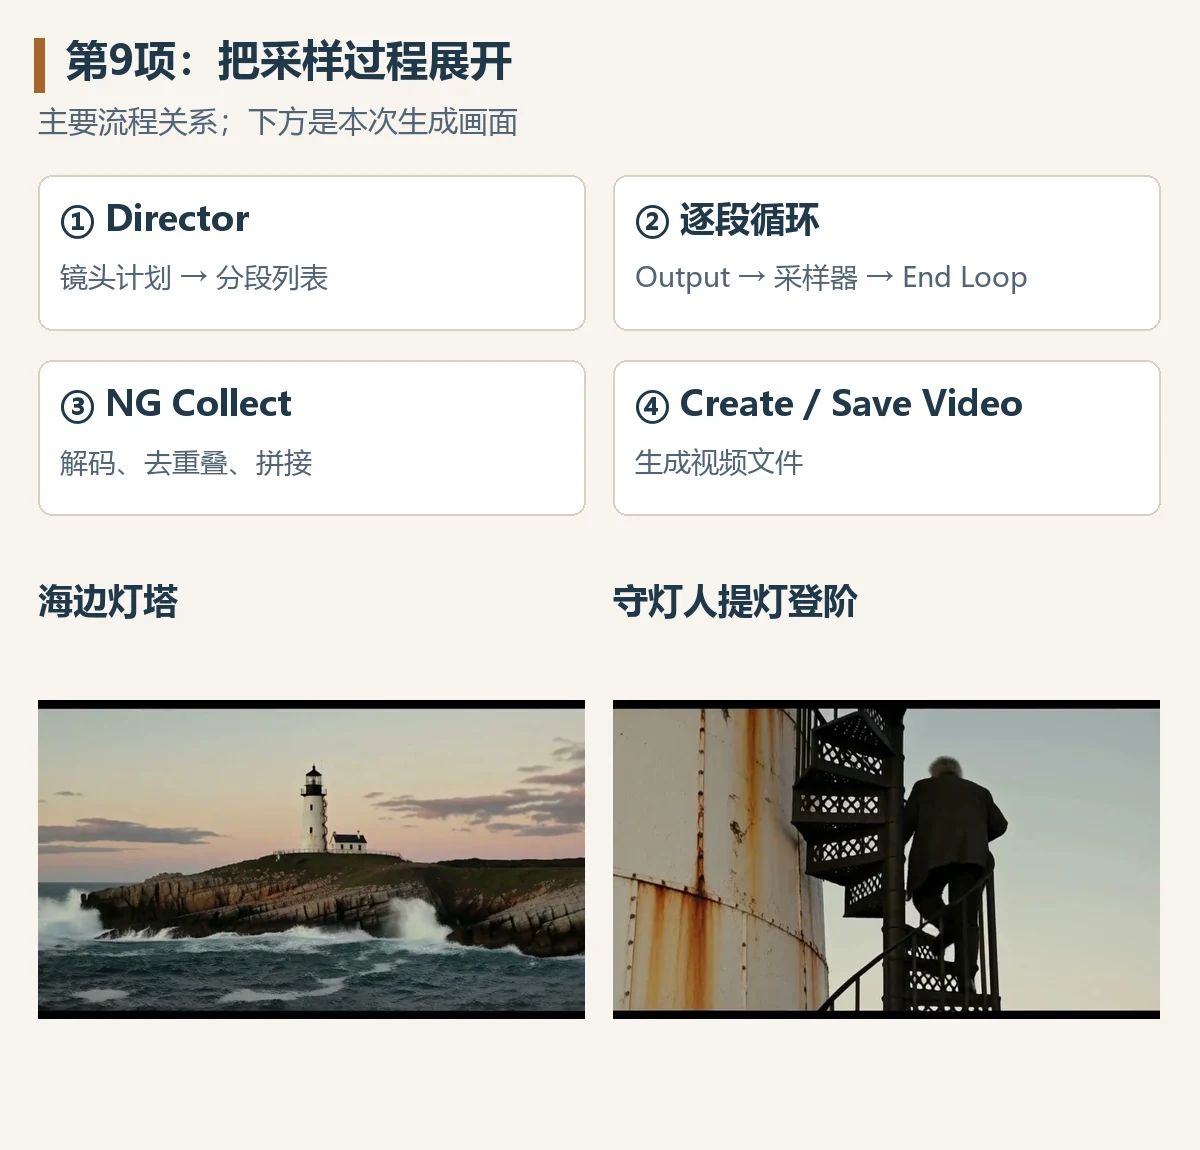 看原图
我沿用示例里的灯塔场景,缩成两个约5秒镜头:先是海边灯塔和浪,接着是守灯人提着灯沿旋转楼梯上行。这次是768×448、Turbo 8步,生成约3分30秒,成片同样10.125秒。
抽帧能看到外景切到楼梯内景,守灯人向上走,后段逐渐离开画面。音轨的机器转写识别到了预设的两句英文台词;声音和嘴型是否自然,还要结合视频听看。
这次我跑的是示例已有的采样链,没有另外增加第二阶段采样,也没有比较不同采样器的画质。所以,它在这轮最直接的意义是:想换采样器、引导节点或增加采样阶段时,有一条展开的流程可以接着改。 只想按镜头出片,前面的Render Sequence更省事。
还有一个使用差别值得提前记住:项目进阶指南说明,这个原生循环会重新渲染每一段。前面Render Sequence的中断续跑能力,不能直接搬到这条循环上。
手里有参考视频,先分清想保留什么
这三个工作流,我会这样选:
- 想借用原片动作,重新生成自己的角色画面:从第7项Control video开始,先检查姿态片是否完整、文件有没有选对。
- 想保留原片场景,只改其中的人或物:看第8项Inpaint,重点检查遮罩、素材时间对应关系,以及重画后背景和动作的变化。
- 已经需要自己改采样节点:再打开第9项Custom sampling;日常出片先用封装好的流程。
接下来真要拿它做内容,我会先挑一小段目标动作,把人物、姿态和遮罩检查清楚。10秒里能看出的偏差,没必要等整条长片渲染完再发现。
智能搭子 · 和你一起把AI真正用起来 · 真实体验 · 客观判断 · 持续探索
测试环境
耗时是单次生成记录,不代表通用性能。
- 显卡
- RTX 5070 12GB
- ComfyUI 核心
- 0.37.0
- H3 Director
- v1.0.0
- 第 7、8 项
- 448×672 · Ref2VA Turbo 6 步
- 一条 10 秒
- 约 3.5–4.3 分钟
- 实测日期
- 2026-10-30
来源与使用范围
用到的素材和工具来自不同作者,使用前请看清各自的范围。
可以这样用
H3 Director 节点是 GPL-3.0 开源,可以用、可以改;改过再分发,也要保持开源。
不要这样用
把项目自带的示例人物、故事板等素材单独拿去再分发或商用;没读 MiniMax H3 社区许可协议原文就用于商业项目。
节点:seesee75-commits/ComfyUI-MiniMaxH3-Director(v1.0.0);模型:Comfy-Org/MiniMax-H3。
写在最后
文中的结果都是我在自己电脑上实测的,换一台电脑、换个软件或模型版本,结果可能不一样。
模型和工具的版权归原作者,本站只链接官方下载地址;可下载的工作流和脚本按现状分享,运行前请先看一遍内容,重要文件先备份。
声音克隆、换脸换装、AI 生成的图片、视频和音乐,请只用你自己的或已经获得授权的素材,发布和使用时遵守法律法规和平台规则。
如有内容涉及侵权,请通过公众号「智能搭子」私信联系我,核实后会及时删除。