 智能搭子
我用17秒录音实测IndexTTS 2.5:声音更像了,但情绪越强越容易跑音色
大家好,我是你的智能搭子阿洁。
前面连续测试视频模型时,我一直在想一个问题:画面已经能本地生成了,角色对白能不能也在本地完成?最好既能克隆指定音色,又能让同一个角色表达开心、委屈和愤怒。
这次我在RTX 5070 12GB上安装了IndexTTS 2.5的ComfyUI节点,实际生成了25条音频,测试了8维情绪向量、情绪参考音频、文本描述和声音克隆。
最后的结论不是简单的“能”或“不能”:它能克隆,也能加情绪;但参考录音、语速和情绪强度会互相影响。情绪越强,克隆音色越容易被带偏。
先看测试条件
- GPU:NVIDIA GeForce RTX 5070 12GB;
- ComfyUI:0.36.0隔离环境;
- IndexTTS 2.5模型约10.22GiB,官方文件校验通过;
- 节点:Comfyui-indextts25-xzg 2.0.1;
- 中文固定台词:你终于回来了,我在这里等了你整整一天;
- 正式克隆参考:一段约17秒的自然普通话录音;
- 所有正式样本均由我在ComfyUI界面操作并完整听检。
本文的“明显、轻微、相似、机械”等描述都是作者主观听感,没有包装成盲听准确率。
第一种:直接拉情绪向量,快,但不均衡
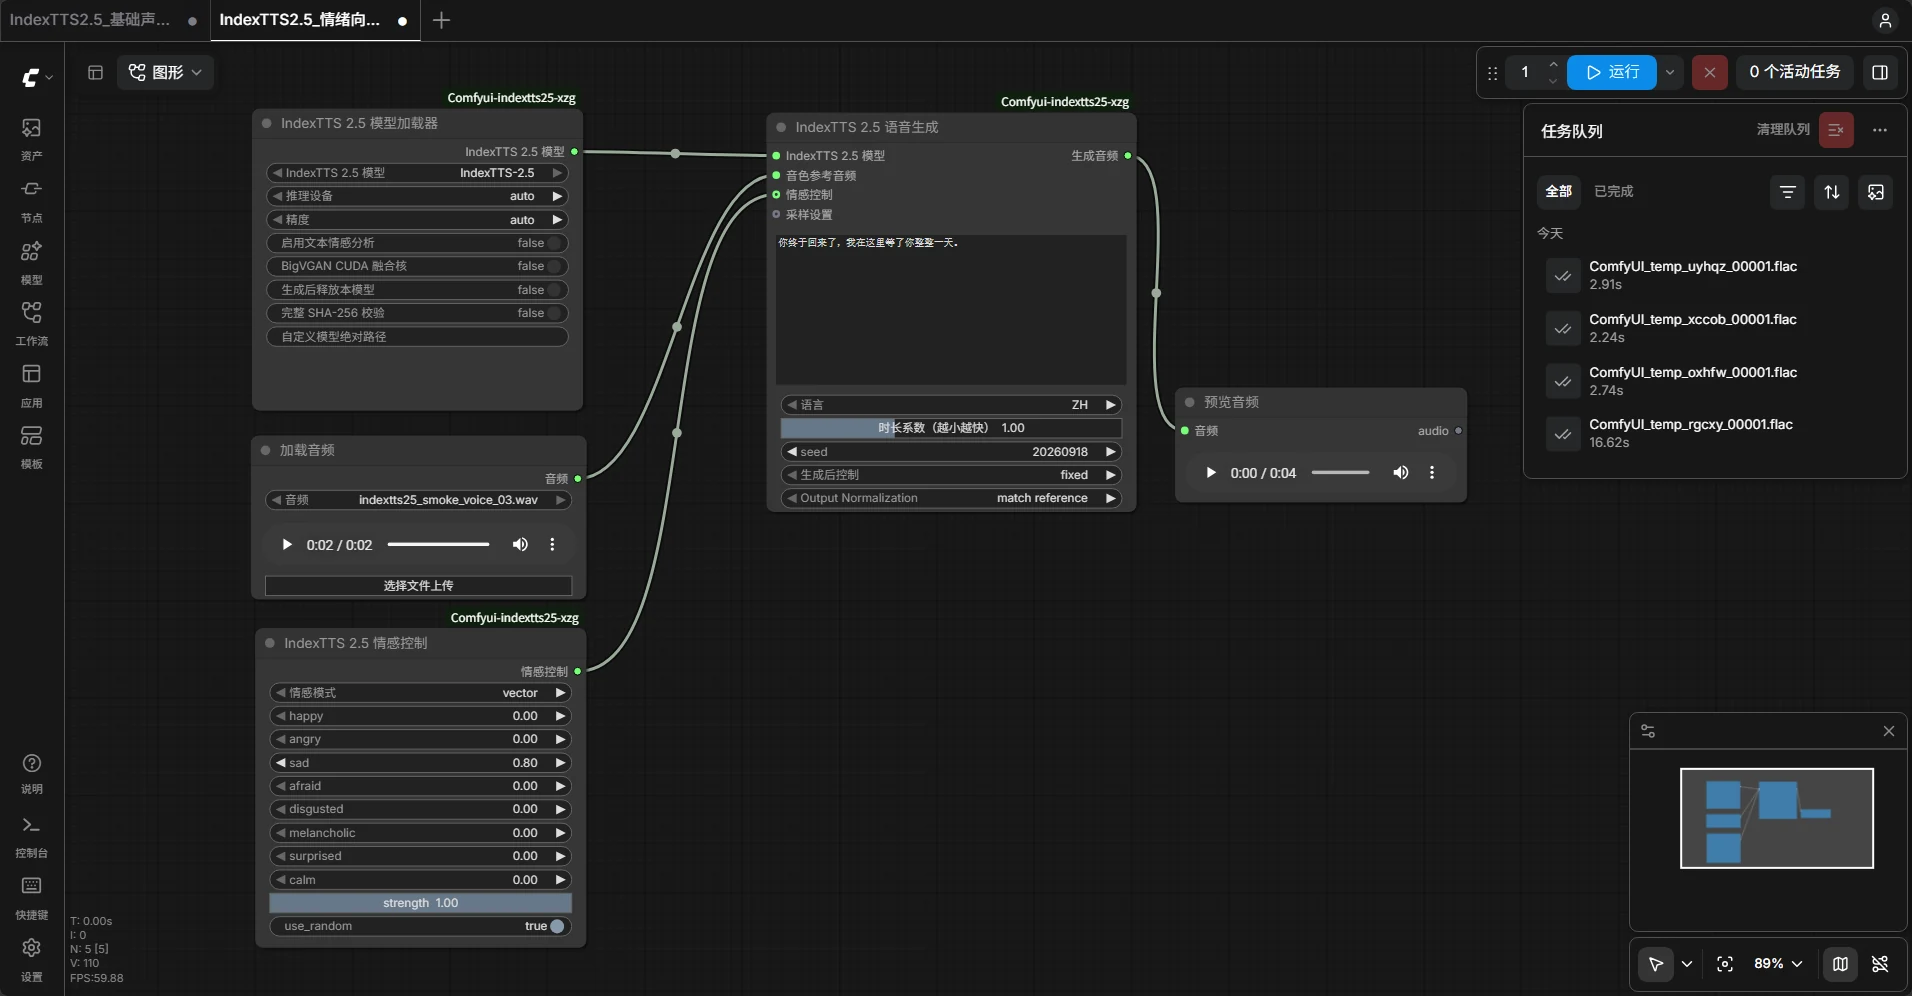
节点提供happy、angry、sad、afraid等8个方向。我固定台词和Seed,分别把单项强度设为0.80。
结果差别很大:开心没有明显开心感;愤怒更像轻度不耐烦;悲伤能听到委屈;恐惧主要表现为语速稍快,没有形成明确害怕感。
 看原图
向量模式最大的优势是快。模型热运行时,几秒钟就能完成一条短句。但它更像快速定方向,不能保证每一种情绪都同样鲜明。
第二种:情绪参考音频,变化更明显
我又加载了一段悲伤参考音频,把情绪模式切换到reference_audio。
strength为1.00和0.60时,语气变化都很明显;降到0.30后,只剩一点变化,整体更平静。当前样本里,0.60是情绪影响和音色保持之间更有测试价值的档位。
但这里有一个容易忽略的问题:参考音频带来的不只是“悲伤程度”,它还可能把节奏和声音特征一起带进来。后面的克隆测试里,这个问题更加明显。
第三种:用文字描述情绪,方向最准,但速度最慢
文本模式需要额外加载Qwen情感模型。我输入:
悲伤、委屈、低落,像等待了很久后终于见到对方。
后台把它解析为sad 0.30、melancholic 0.70;乘以strength 0.60后,实际向量是sad 0.18、melancholic 0.42。我听到的结果确实有悲伤感。
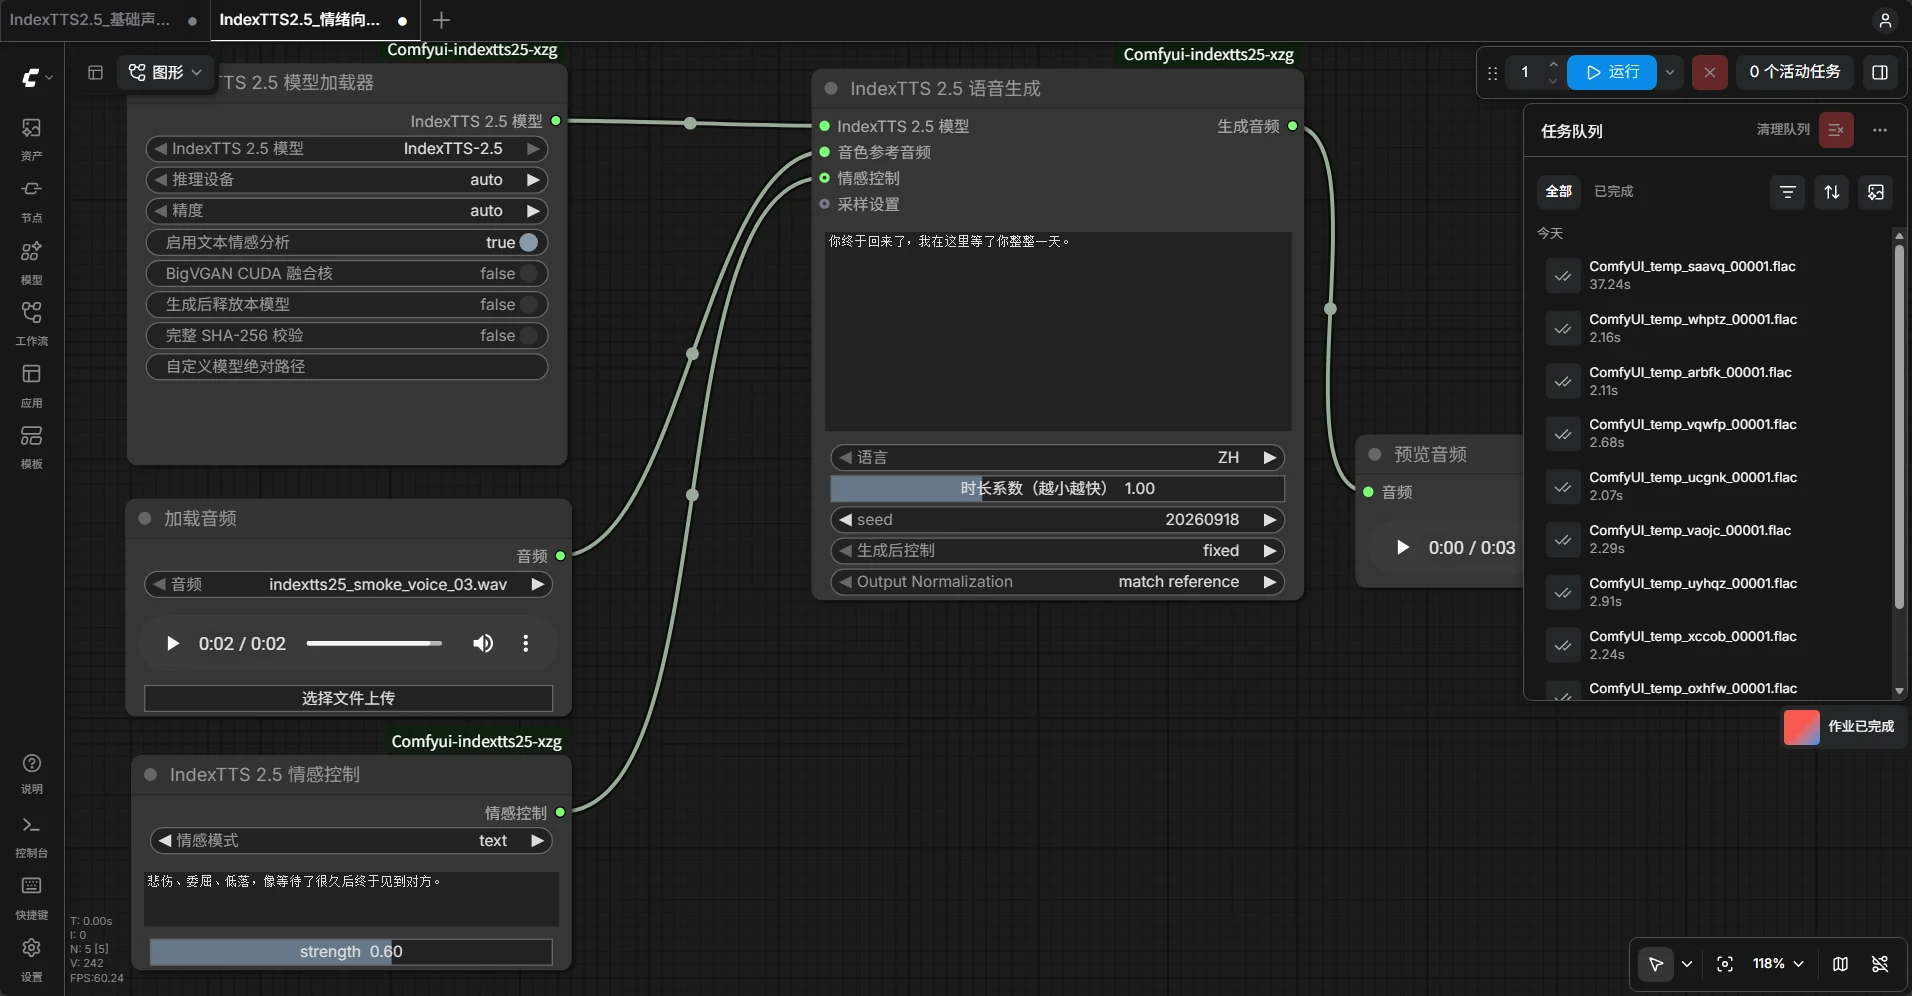 看原图
换成开心描述后,方向也会转向开心,但听感只有一点开心。把strength从0.60提高到1.00,并没有明显更开心;把台词改成语义明确的开心句后,效果才好一些。
这说明情绪强度并不是简单的线性旋钮,台词本身也会限制表达。
代价是速度。向量和参考音频短句通常约2—4秒完成,文本模式的非缓存生成却用了34—59秒。本机上,它适合需要明确情绪方向的少量对白,不适合大量快速试音。
17秒参考录音,克隆效果比9秒更好
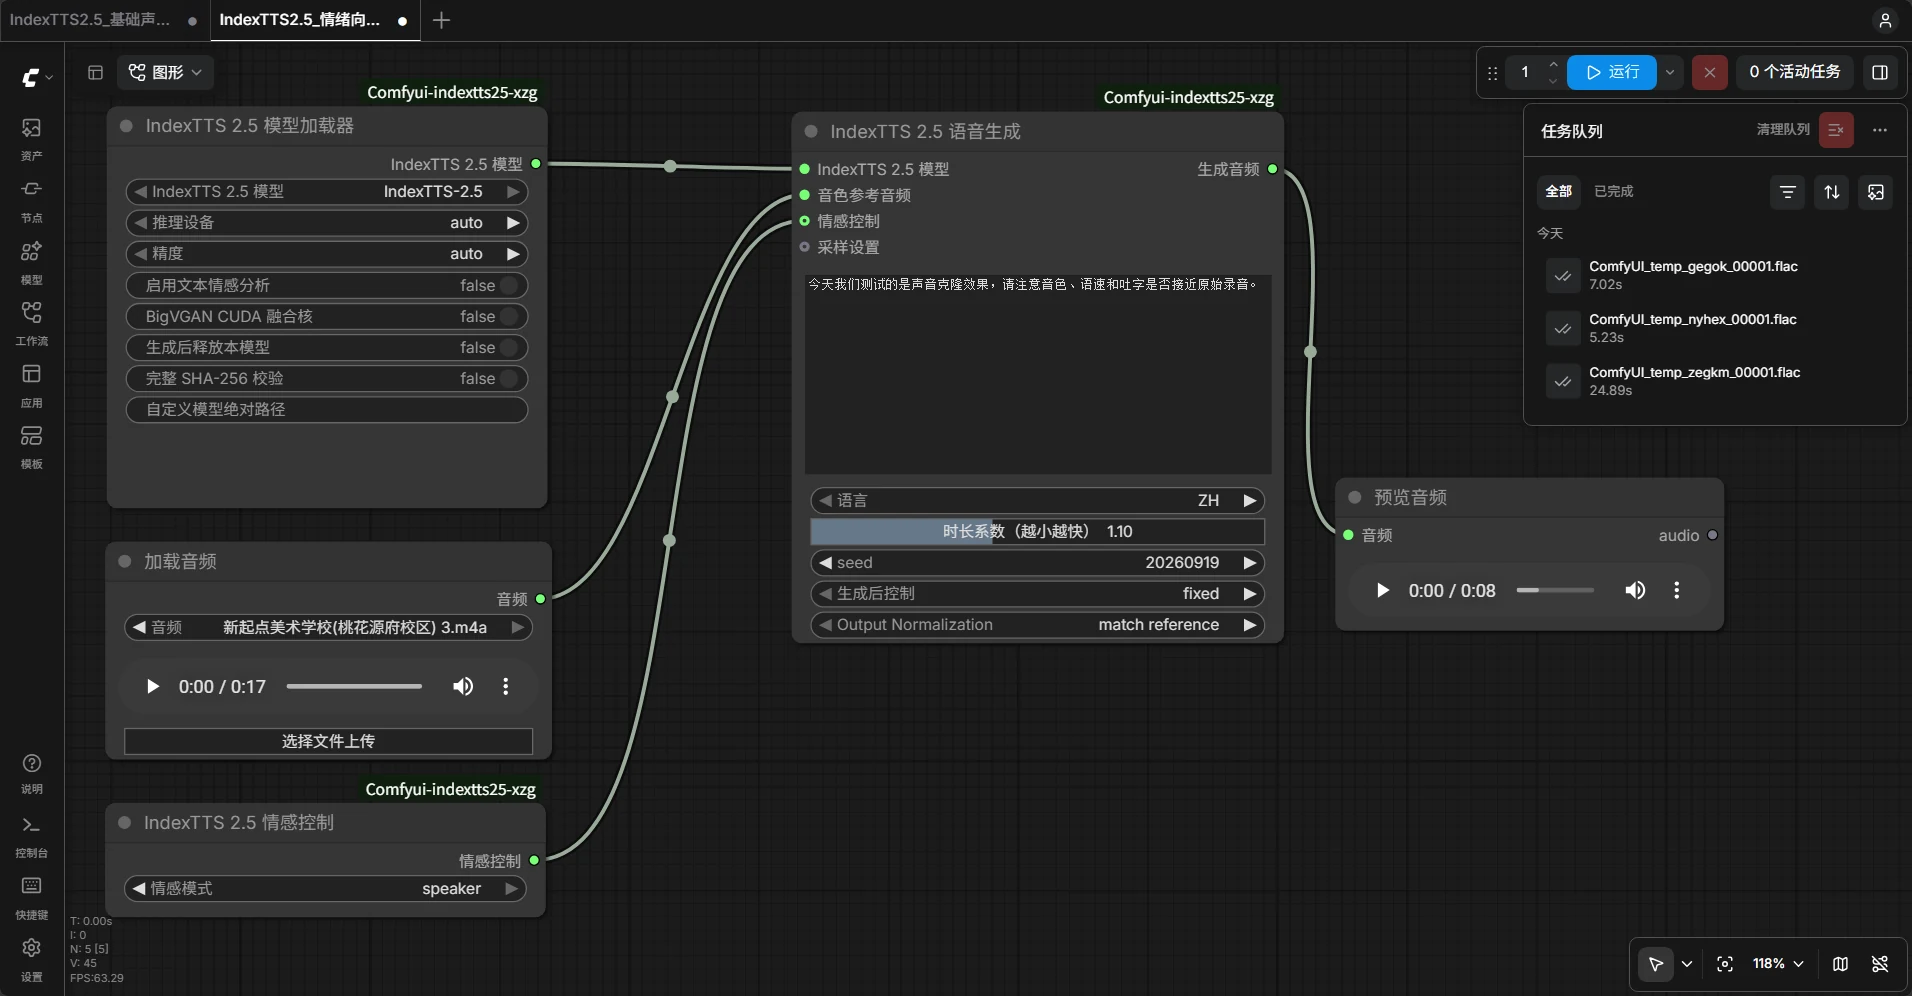
声音克隆不需要训练LoRA,只要把参考录音接到音色输入。我先用一段约9秒录音测试,结果只有几分相似:音色有一点像,但与原声仍有区别,语速也偏快。
后来重新录制约17秒干净普通话,保持生成台词和参数不变,主观效果比前面更好。
 看原图
这里不能简单归因于“多了8秒”,因为新录音同时更干净、内容也更完整。能确认的是:参考素材本身比继续微调参数更重要。
语速能调正常,机械感不一定消失
生成节点的时长系数越小越快。同一条短句里:
| 时长系数 | 成品时长 | 主观听感 |
|---|---|---|
| 1.10 | 5.00秒 | 太慢,不自然 |
| 1.00 | 4.55秒 | 仍偏慢 |
| 0.95 | 4.32秒 | 中间档 |
| 0.85 | 3.87秒 | 语速较正常,但略机械 |
所以时长系数可以修正节奏,却不是“自然度”按钮。不同长度、不同语义的台词需要单独听,不能把一个数值套到整篇对白。
最关键的一组:克隆音色和强情绪能不能兼得?
我保留17秒克隆参考,再接入悲伤情绪参考音频。
strength 0.60时,情绪参考的影响很明显,但生成声音也开始偏向情绪参考,原来的克隆音色被带偏。
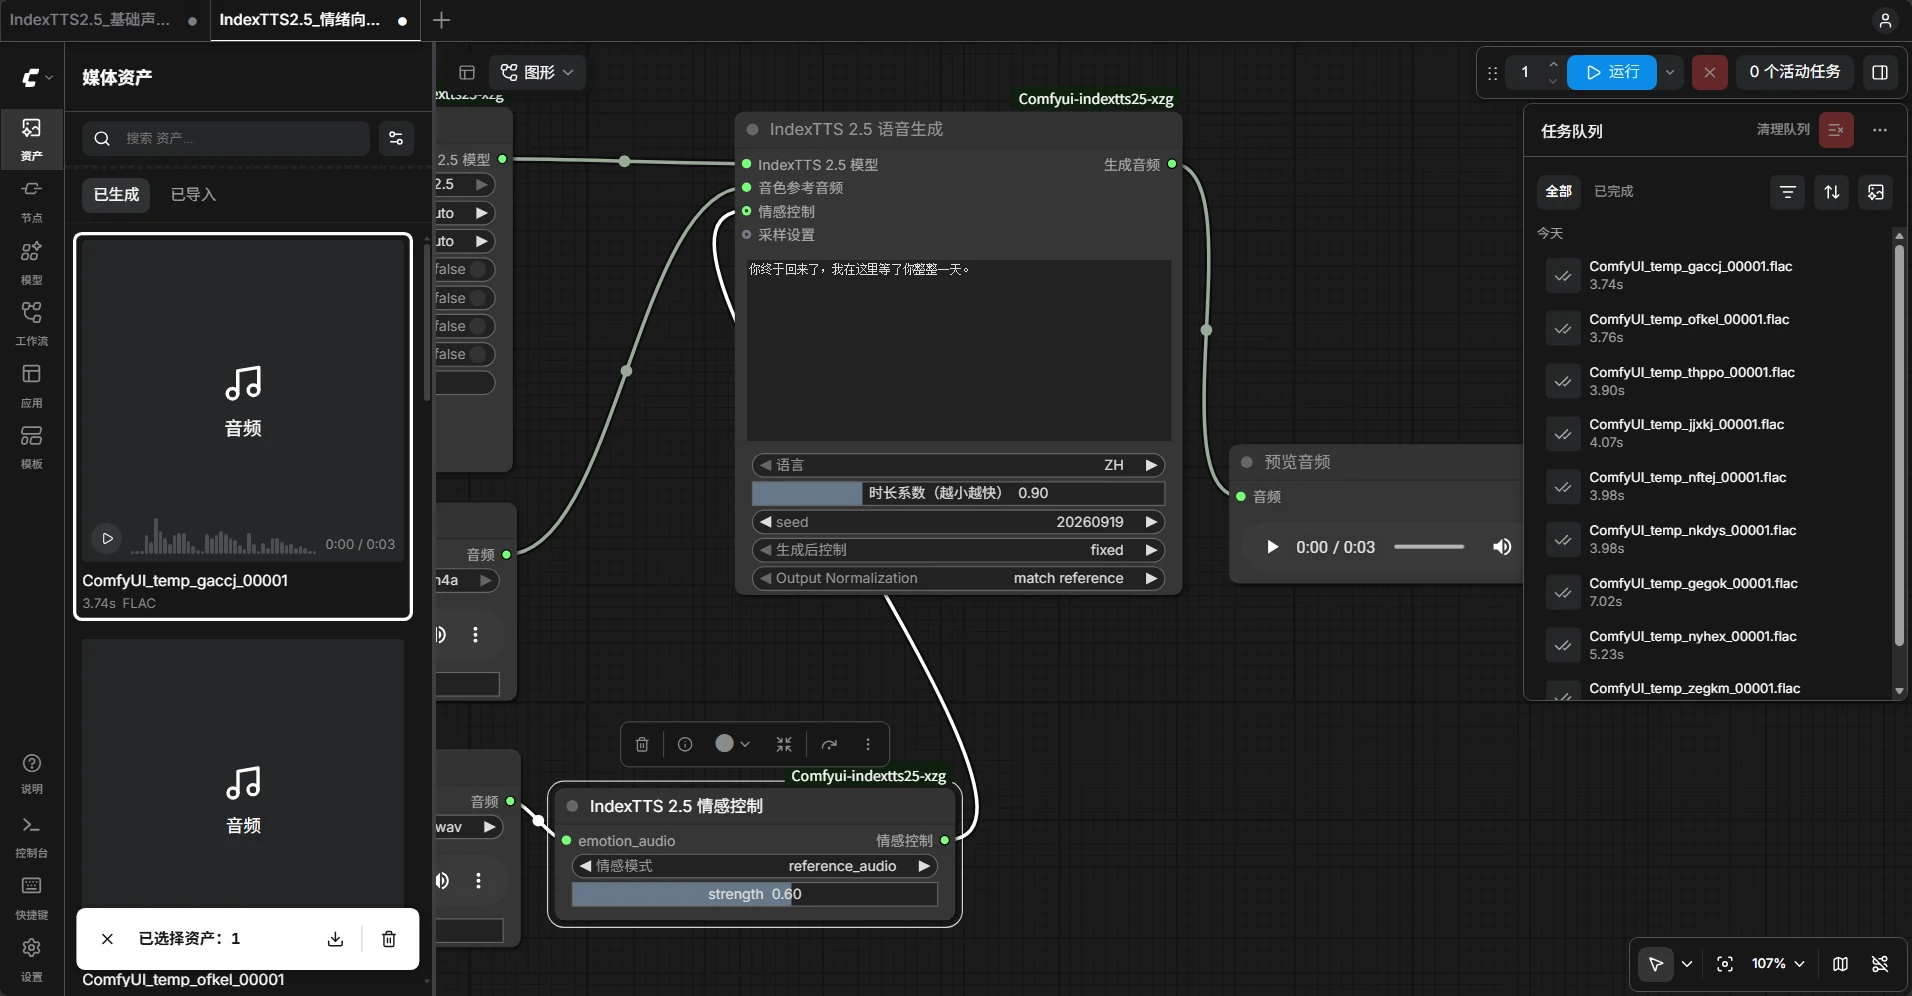 看原图
把strength降到0.30后,声音重新更接近克隆参考。由于这次没有单独确认悲伤感还剩多少,我不会把它写成“情绪和音色同时完美保留”。
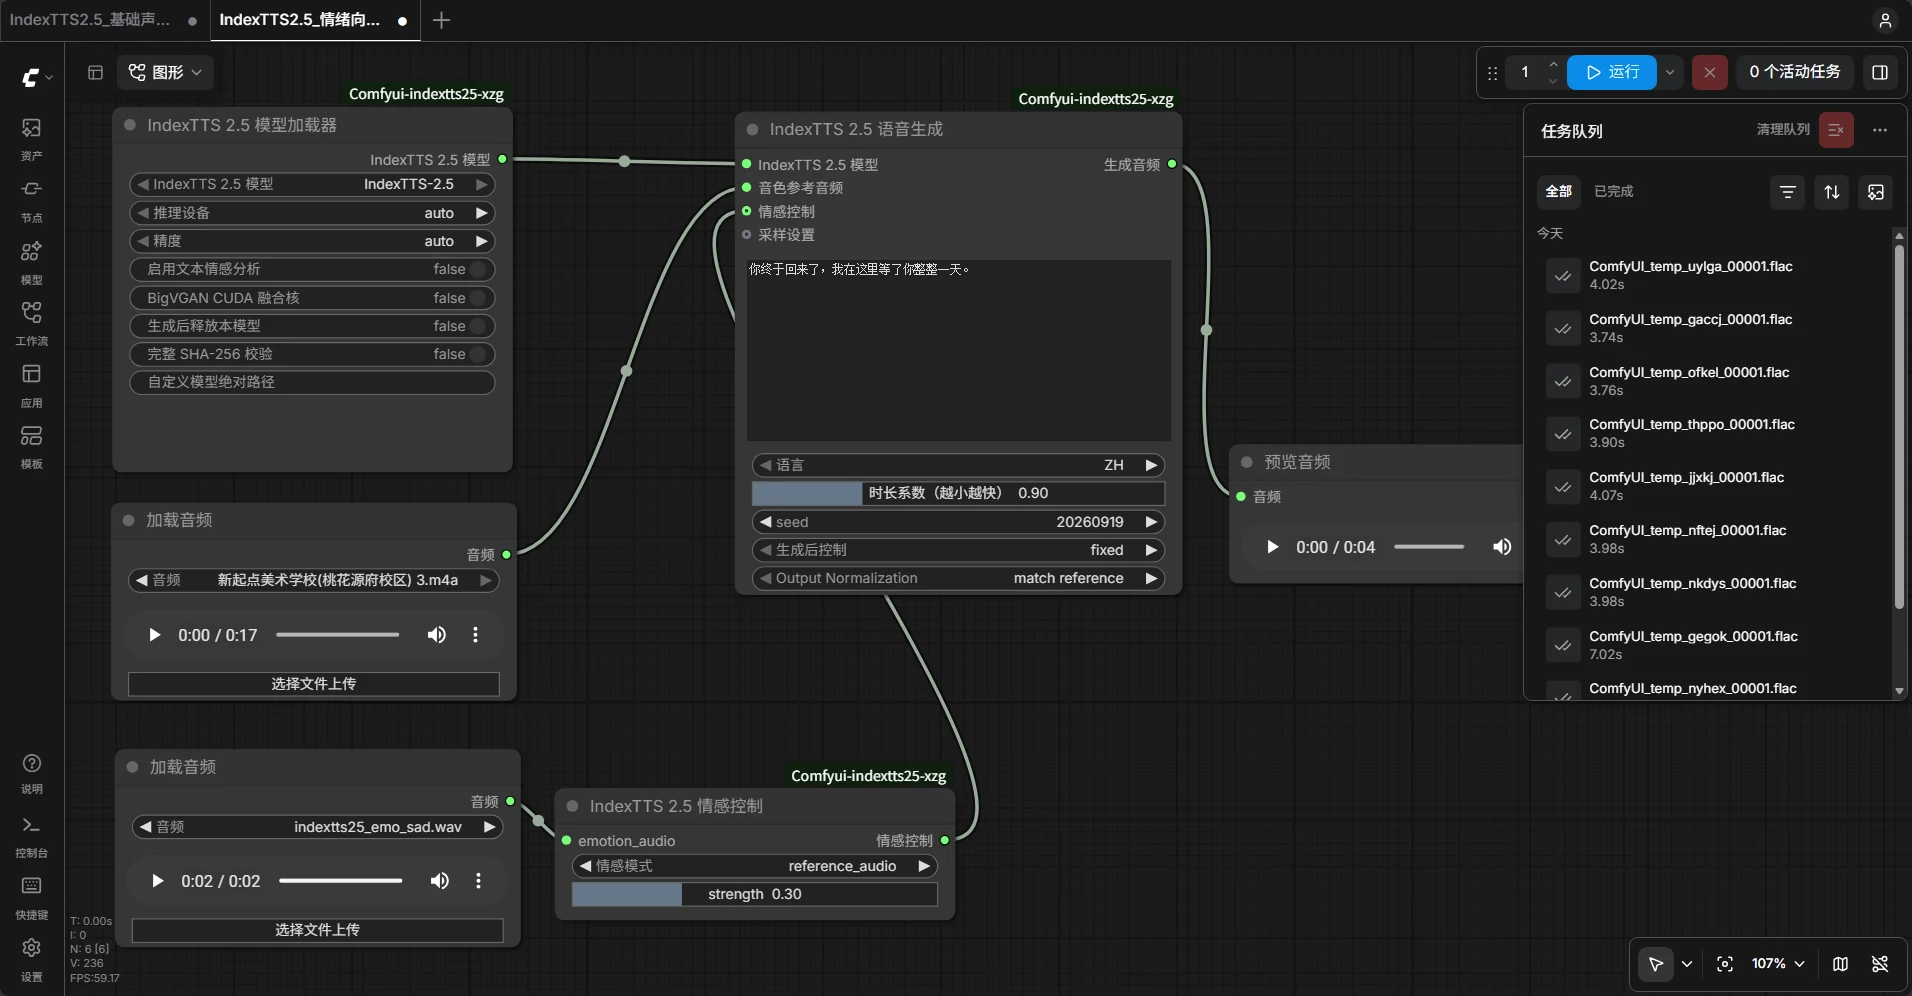 看原图
当前最实际的用法,是先保证角色音色,再用较低强度补一点情绪;如果追求强烈表演,就要接受音色可能发生偏移。
怎么和MiniMax H3视频结合?
这套语音可以接到MiniMax H3视频制作前面,形成一条更完整的角色生产线:先确定角色台词,用IndexTTS 2.5生成不同情绪版本;选定音轨后,再把它作为H3音频参考或后期对白,与人物镜头、口型和字幕组合。
它适合三类场景:短剧角色试音、数字人口播、多镜头视频里的固定角色对白。向量模式适合快速试方向;参考音频适合模仿具体表演;文本模式适合少量需要明确情绪的关键句。
但本期只完成了语音侧测试,没有把这些新音频送入H3生成最终音画同步成片。因此“可以组成工作流”是下一步方案,不是本期已经验证的成片结论。真正接入视频时,还要继续检查口型同步、音频时长、镜头节奏和跨镜头音色一致性。
我的最终判断
实际怎么选
重视速度时先用向量模式;重视具体表演时用参考音频;重视情绪方向时用文本描述。声音克隆项目优先准备干净参考录音,再从低strength开始加情绪。
IndexTTS 2.5已经能在本地完成实用的声音克隆和情绪控制,热运行短句大多只需几秒。17秒干净参考比随手录制的9秒音频更可靠,参考情绪也确实能让表达发生变化。
它目前还不是“上传一段声音,就能稳定复制原声并随意表演”的无损工具。克隆相似度、机械感、逐句语速,以及强情绪导致的音色偏移,都需要人工听检。
如果把它放进MiniMax H3短剧或数字人流程里,我会把它定位为一个可快速迭代的本地角色配音工具:先用它做多版本试音,再挑选最合适的一条进入视频,而不是直接批量生成后全部采用。
智能搭子 · 和你一起把AI真正用起来 · 真实体验 · 客观判断 · 持续探索
测试环境
短句耗时为模型热运行时的记录;文字描述模式要额外加载情感模型,所以慢很多。
- 显卡
- RTX 5070 12GB
- ComfyUI
- 0.36.0(单独一套环境)
- 节点
- Comfyui-indextts25-xzg 2.0.1
- 模型
- 约 10.22GiB
- 短句一条
- 约 2–4 秒
- 文字描述模式
- 约 34–59 秒
- 实测日期
- 2026-09
来源与使用范围
用到的素材和工具来自不同作者,使用前请看清各自的范围。
可以这样用
用自己的声音、或已经获得授权的声音做克隆;模型按 bilibili 模型使用许可协议使用,商用前先读许可原文。
不要这样用
没经过本人同意克隆别人的声音(模型不会核实参考录音是否获得同意);把本页试听音频下载下来另作他用。
模型:IndexTeam/IndexTTS-2.5;ComfyUI 节点:Comfyui-indextts25-xzg。
写在最后
文中的结果都是我在自己电脑上实测的,换一台电脑、换个软件或模型版本,结果可能不一样。
模型和工具的版权归原作者,本站只链接官方下载地址;可下载的工作流和脚本按现状分享,运行前请先看一遍内容,重要文件先备份。
声音克隆、换脸换装、AI 生成的图片、视频和音乐,请只用你自己的或已经获得授权的素材,发布和使用时遵守法律法规和平台规则。
如有内容涉及侵权,请通过公众号「智能搭子」私信联系我,核实后会及时删除。