 智能搭子
12GB显卡怎么本地跑MiniMax Music 3?我用FP16生成了一首5分钟中文歌
本文附 1 份工作流、1 个下载脚本和 3 份提示词与歌词导入 ComfyUI 就能用;模型清单和官方下载地址也在文末。
去下载大家好,我是你的智能搭子阿洁。
这次我没有只测试MiniMax Music 3能不能发出声音,而是想解决一个更实际的问题:
普通人能不能在一台12GB显卡的Windows电脑上,搭好一套本地AI写歌工作流,并真正生成一首歌词完整、结尾自然的中文歌?
最后,我用RTX 5070 12GB和FP16音乐主模型,生成了一首4分55秒的中文情歌《后来每一天》。从任务开始到文件保存,用了9分06秒。完整试听后,歌词全部唱完,结尾自然,我的主观评价是很好听。
但过程并不是一次就顺利。
两分钟测试因为歌词太长,结尾没有唱完;第一版旅行歌即使跑满300秒,歌词仍然被截断。直到我把歌词缩短约30%,第二版才在4分46.8秒内全部唱完,并留下自然尾奏。
所以这篇文章不只告诉你模型放在哪里,还会讲清楚:
- 12GB显卡应该选哪套模型;
- ComfyUI怎样升级和导入工作流;
- 为什么5分钟不等于一定能唱完;
- 怎样从主题、音乐提示词和歌词结构做出一首完整歌曲。
01 先说结论:12GB能跑FP16,但不能只看显存
我的实测组合是:
- 显卡:NVIDIA GeForce RTX 5070,12GB物理显存;
- 系统内存:32GB;
- ComfyUI:0.33.0;
- PyTorch:2.13.0+cu130;
- 音乐主模型:FP16;
- 文本编码器:裁剪INT8版本;
- 音频VAE:MiniMax Music 3 DAV;
- 长音频解码:开启Tiled Decode。
这套组合成功完成30秒、120秒和三次接近5分钟的正式生成,关闭并重启ComfyUI后,30秒样例也再次生成成功。
但“12GB显卡能跑”不能理解为整套任务只用了12GB资源。
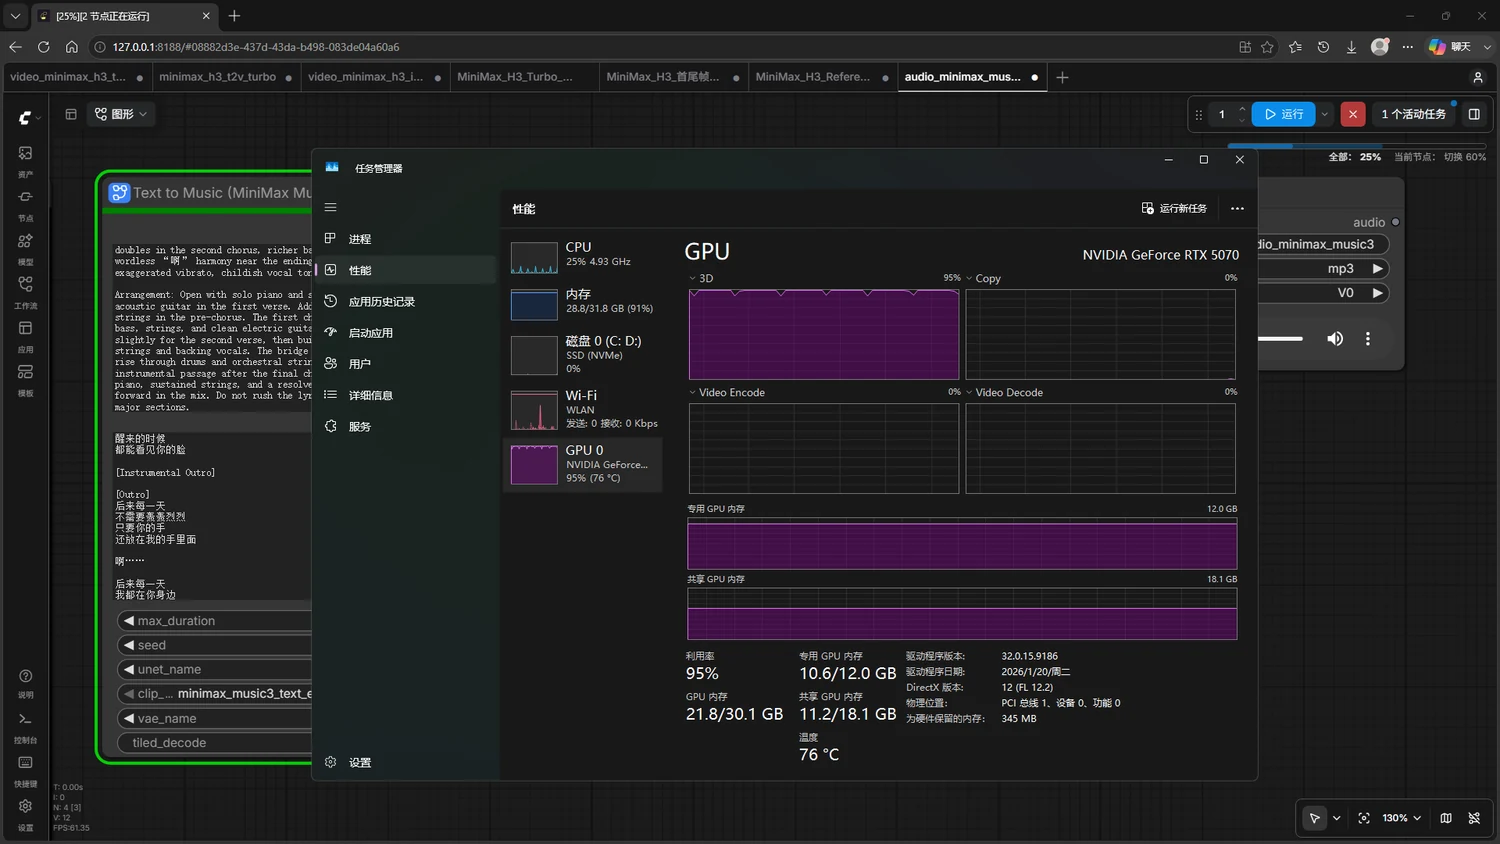
五分钟歌曲生成时,我在任务管理器某一时点观察到:独立显存约10.6/12GB,系统内存约28.8/31.8GB。Windows还显示使用了约11.2GB共享GPU内存。
这里的共享GPU内存来自系统内存,不代表显卡突然变成了21.8GB物理显存。长歌曲能够完成,依赖DynamicVRAM、权重卸载、共享内存和32GB系统内存共同工作。
结论不是“所有12GB显卡都能轻松跑”,而是这台RTX 5070 12GB+32GB内存的电脑,在当前环境和参数下跑通了。
 看原图
02 为什么我没有把三个模型都选最高精度
官方工作流需要三类文件:音乐主模型、文本编码器和音频VAE。
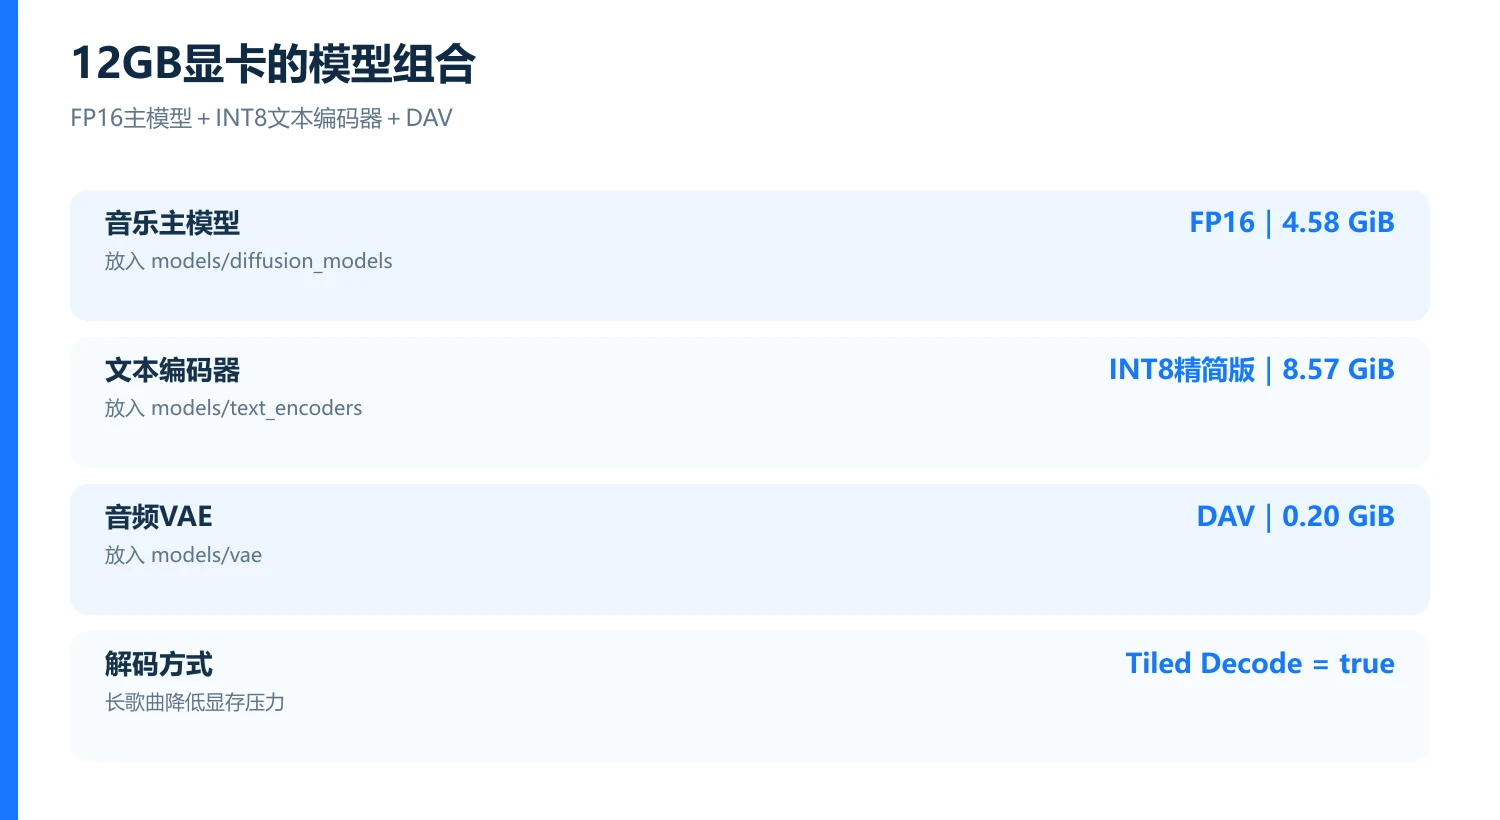
我的选择不是全FP16,也不是全INT8,而是一个质量和资源占用之间更现实的组合。
| 组件 | 本次选择 | 实际大小与作用 |
|---|---|---|
| 音乐主模型 | minimax_music3_dit_fp16.safetensors |
4,914,197,682字节;保留主生成模型的FP16质量 |
| 文本编码器 | minimax_music3_text_encoder_pruned_int8_convrot.safetensors |
9,196,611,886字节;降低大文本编码器的内存压力 |
| 音频VAE | minimax_music3_dav.safetensors |
216,696,128字节;负责音频解码 |
三个文件合计约13.35GiB。
为什么这样选?
因为主模型直接影响最终音乐生成,我先保留FP16;文本编码器体积更大,使用官方工作流提供的裁剪INT8版本;解码阶段再打开Tiled Decode,降低长音频的显存压力。
 看原图
如果这套FP16主模型在你的电脑上实际出现显存溢出,再考虑把主模型换成官方提供的INT8版本。不要在还没跑过时,就因为看到“12GB”先把所有组件都降到最低精度。
03 搭工作流之前,先做两件保护动作
第一步:确认空间
我安装前的D盘剩余空间是292.56GB,模型本身约13.35GiB。
实际使用还要给下载缓存、模型重建、ComfyUI运行缓存和音频输出留空间。模型文件不能刚好塞满磁盘。我的建议是至少预留20GB,准备长期生成时留30GB以上更安心。这个数字是安装余量建议,不是模型官方最低要求。
第二步:备份旧工作流
我没有新装第二套ComfyUI,而是在已经跑通MiniMax H3的便携环境中升级。
升级前,我先备份了:
ComfyUI/user/default/workflows/
原目录有6个工作流,共203,592字节;备份后再次核对,文件数量和总字节数一致。
如果你已有能正常运行的模型环境,更新前至少保存工作流和重要自定义节点清单。这样升级失败时,知道需要恢复什么。
04 更新ComfyUI,但不要顺手改掉所有依赖
我原来的ComfyUI是0.30.0,当时没有MiniMax Music 3专用节点,因此不能直接运行官方工作流。
我使用便携版自带的更新脚本,把ComfyUI更新到0.33.0。更新后出现了两个关键节点:
MiniMaxMusic3TextEncode
EmptyMiniMaxMusic3LatentAudio
更新脚本最后还询问是否继续升级PyTorch。我选择停止,保留原来已经跑通H3的2.13.0+cu130。
原因很简单:这次目标是补上Music 3支持,不是为了“版本越新越好”把已经稳定的旧工作流一起改变。
升级完成后,我再次检查了原来的6个H3工作流,数量和总字节数没有变化,旧的H3自定义节点也能正常加载。
05 下载三个模型,放到正确目录
模型来自Comfy-Org在Hugging Face提供的MiniMax Music 3仓库。
对应目录如下:
ComfyUI/
└─ models/
   ├─ diffusion_models/
   │  └─ minimax_music3_dit_fp16.safetensors
   ├─ text_encoders/
   │  └─ minimax_music3_text_encoder_pruned_int8_convrot.safetensors
   └─ vae/
      └─ minimax_music3_dav.safetensors
我的第一次直接下载并不顺利:curl多次在Hugging Face的443连接阶段超时;便携环境自带的hf.exe又包含失效的构建机路径。
最后,我使用便携Python直接调用huggingface_hub.snapshot_download,通过Xet分块下载并重建三个指定文件。下载与重建约用12分25秒。
下载显示完成以后,我没有立刻开始生成,而是逐个核对字节数和SHA-256:
| 文件 | SHA-256 |
|---|---|
| FP16主模型 | 45494A2B6B69AF115902FF28EAF54118D19067AA54DA01000F3E3EFCE7BA0E34 |
| INT8文本编码器 | 010B7416D2336A08C711BC22EE65849C9623069DDB7D89BEC011A75699E52014 |
| DAV | 2A32155B769BE01445FCC2A8663B910FC9E1751E18DC1C3EC528064512D9EF0C |
三个文件的大小和哈希均与官方仓库记录一致。
文件名正确,只能说明它“看起来像模型”;哈希一致,才能证明下载内容没有损坏或缺块。
06 导入官方工作流,只改这几个地方
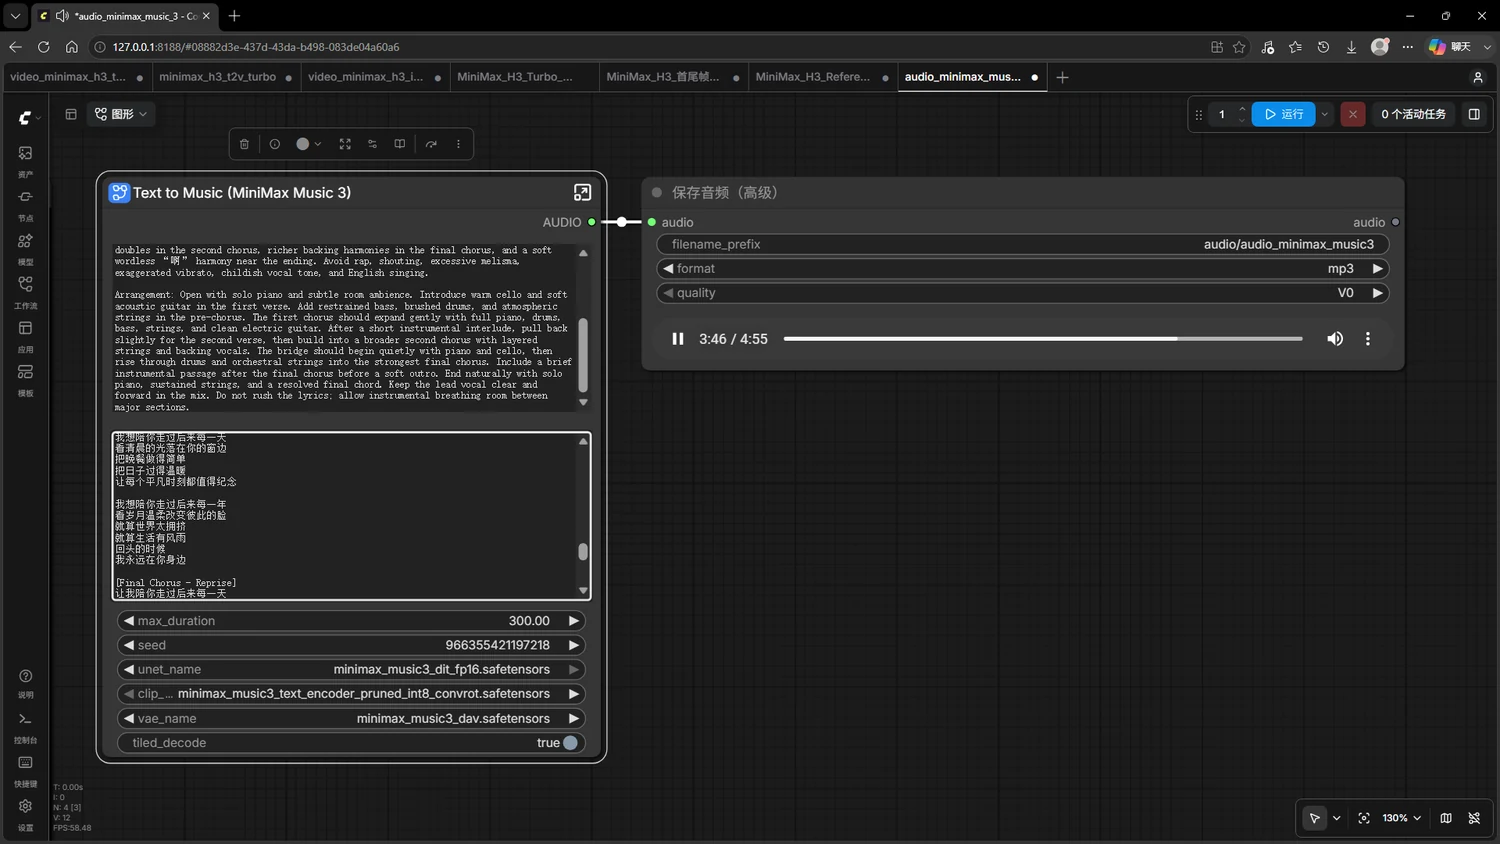
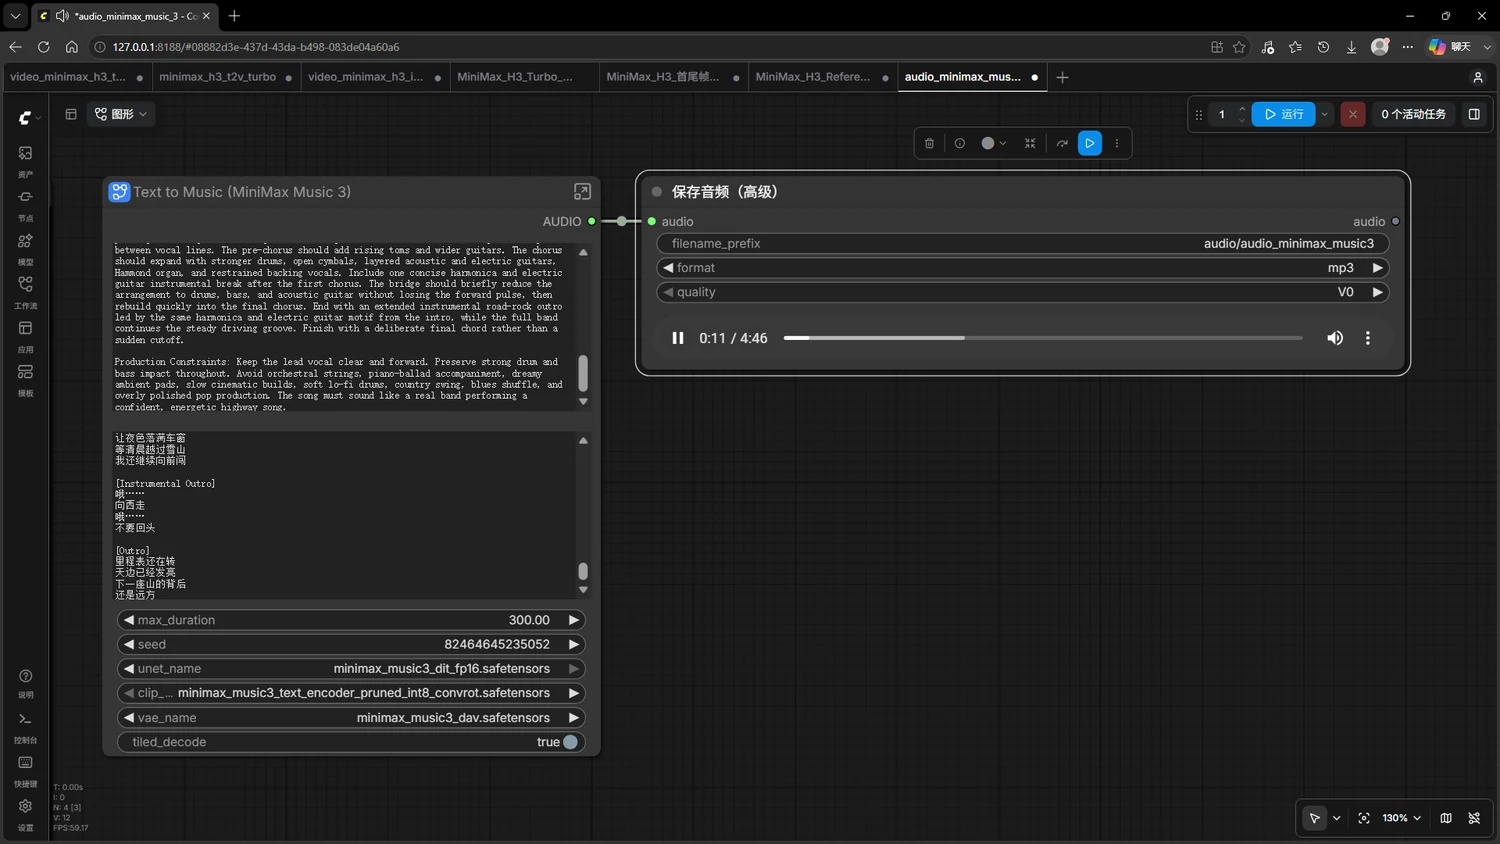
导入官方audio_minimax_music_3工作流后,界面主体只有一个Text to Music子图和一个音频保存节点。
 看原图
第一次使用时重点检查:
unet_name选择FP16主模型;clip_name选择裁剪INT8文本编码器;vae_name选择Music 3 DAV;- 长歌曲把
tiled_decode设为true; max_duration先设30,不要上来就跑300秒;- Caption填写音乐、演唱和编曲要求;
- Lyrics用
[Intro]、[Verse]、[Chorus]、[Bridge]、[Outro]等标签组织结构。
如果节点和模型下拉列表都正常,再跑30秒测试。网页能打开、工作流能导入和音频真正生成,是三个不同层级。
07 我的5次正式生成,实际用了多久
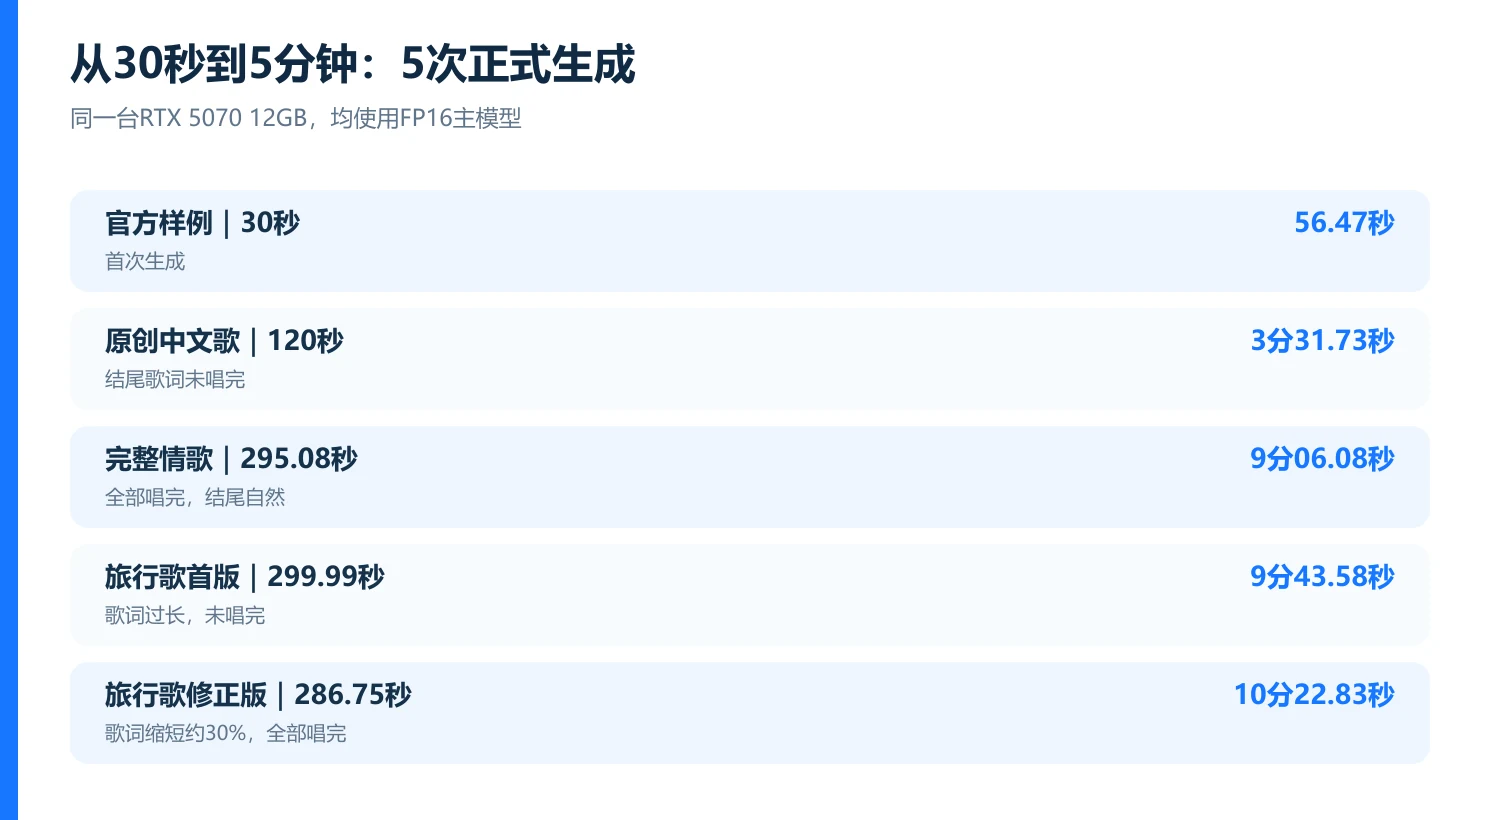
| 测试 | 实际音频时长 | 生成耗时 | 人工验收 |
|---|---|---|---|
| 官方样例 | 29.989秒 | 56.473秒 | 技术生成成功 |
| 《凌晨两点的搭子》 | 119.989秒 | 211.729秒 | 唱得不错,但结尾歌词没唱完 |
| 《后来每一天》 | 295.079秒 | 546.082秒 | 全部唱完,结尾自然,很好听 |
| 《风从山口来》 | 299.990秒 | 583.584秒 | 歌词没唱完,公路旋律感不强 |
| 《向西三千公里》 | 286.755秒 | 622.828秒 | 全部唱完,结尾比较自然 |
 看原图
同一台电脑,音频更短不一定每次都更快。Caption、歌词长度、生成内容和当时的内存调度都会影响耗时。这里记录的是实际样本,不把少量测试包装成稳定性能公式。
关闭ComfyUI并重新启动后,我又跑了一次30秒官方样例,耗时58.97秒,再次成功。到这一步,我才把环境状态从“一次生成成功”改成“安装与重启复现通过”。
08 真正容易踩坑的,不是模型,而是歌词长度
两分钟测试中,我写了Intro、两段Verse、Pre-Chorus、两次Chorus、Bridge和Outro。模型唱得不错,但120秒到了以后,歌词还没唱完。
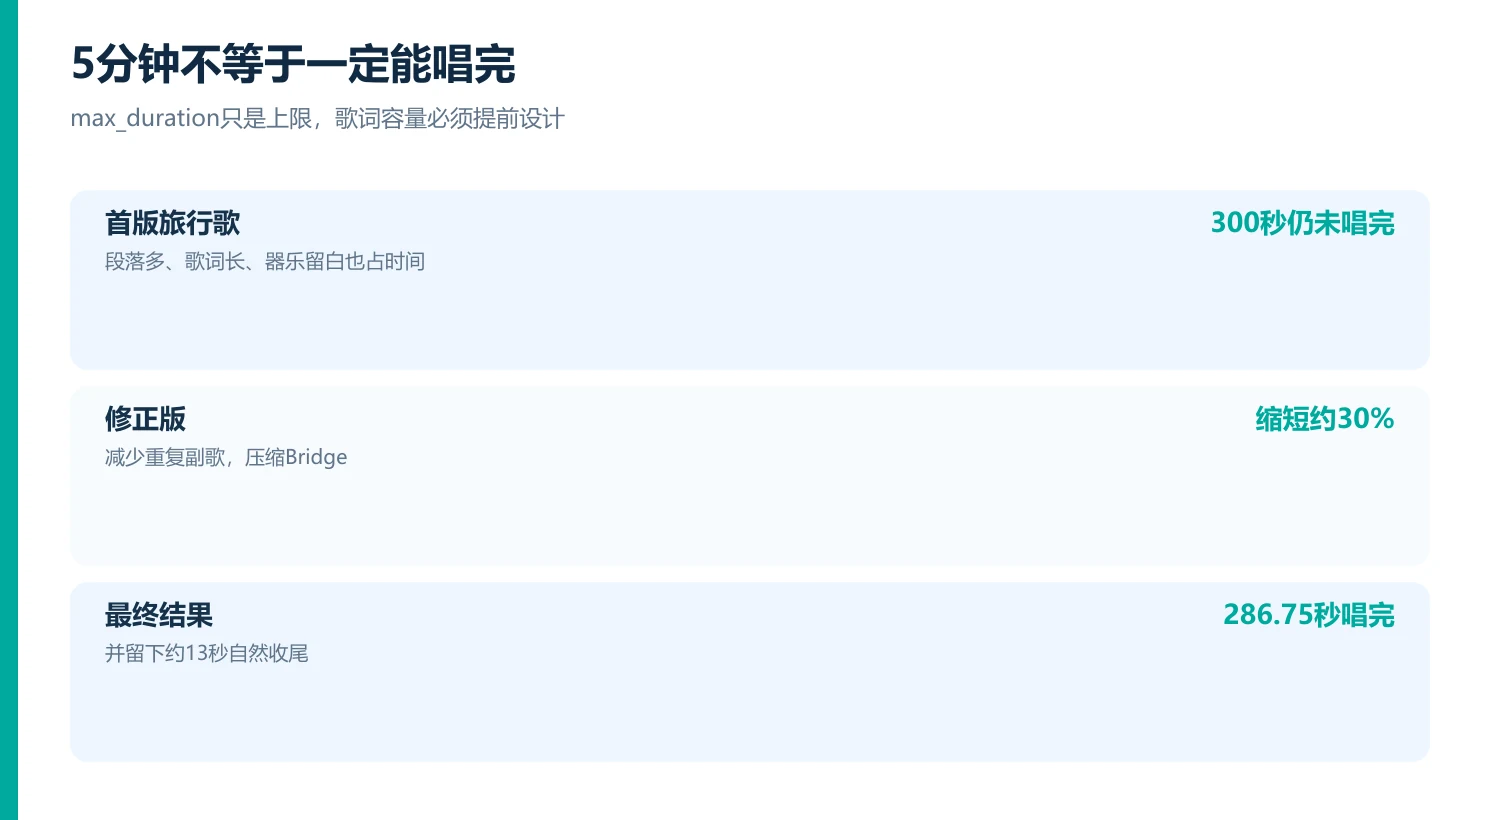
旅行歌第一版更明显:我把max_duration设为300秒,音频真的生成了299.99秒,却仍然没有唱完。
这说明:
max_duration只是允许生成的最长时间,不会保证模型为了塞完所有歌词而自动加快演唱。
歌词标签、重复副歌、器乐段、慢速唱法和自然停顿都会占时间。
我把旅行歌歌词缩短约30%,删除一次重复副歌,压缩Bridge,同时保留必要器乐段。第二版《向西三千公里》在286.755秒内全部唱完,并留下约13秒收尾,结尾比较自然。
 看原图
一个更可靠的写法是先定时长,再设计歌词:
- 2分钟:一段主歌+预副歌+副歌+短桥段或尾声;
- 3分钟:两段主歌+两次副歌+短桥段;
- 4~5分钟:可以加入器乐间奏和最终副歌,但不要把每一段都写满;
- 慢歌、长音和大量器乐留白,需要进一步减少歌词。
这些不是模型官方字数上限,而是本轮实测形成的写作策略。
09 一首歌的提示词,应该分成三层
Music 3的Caption不要只写“中文情歌”或“公路摇滚”。我会把它拆成三部分。
第一层:Global Metadata
说明语言、风格、BPM、调性、拍号、情绪曲线和目标时长。
第二层:Vocal Details
说明人声年龄感、音色、主歌和副歌的演唱变化、咬字、和声,以及不要出现的唱法。
第三层:Arrangement
说明前奏、主歌、副歌、桥段和尾奏分别使用哪些乐器,怎样逐层增加,以及最后如何结束。
可直接替换的结构模板如下:
Global Metadata: Mandarin Chinese [歌曲类型]. [BPM] BPM, [调性], 4/4 time. [整体情绪与情绪变化]. Target duration around [时长].

Vocal Details: One [人声类型] Mandarin lead vocal with a [音色]. [主歌唱法]. [副歌唱法]. Clear Mandarin pronunciation. Avoid [不希望出现的唱法].

Arrangement: Open with [前奏乐器]. Add [主歌乐器]. The chorus should [副歌变化]. The bridge should [桥段变化]. End with [尾奏与收尾方式]. Keep the lead vocal clear and allow breathing room between major sections.
歌词则用结构标签控制:
[Intro]
[Verse 1]
[Pre-Chorus]
[Chorus]
[Instrumental]
[Verse 2]
[Bridge]
[Final Chorus]
[Instrumental Outro]
[Outro]
标签不是越多越好。每增加一段,都要问一句:目标时长里还有没有空间唱完?
10 遇到失败,按这个顺序排查
模型不出现在下拉列表
先核对目录和文件名,再确认ComfyUI是否已经更新到包含Music 3节点的版本。不要反复重启一个根本没有对应节点的旧版本。
下载完成但模型加载失败
核对精确字节数和SHA-256。网络中断可能留下看似正确、实际不完整的大文件。
FP16运行时显存溢出
先关闭其他占用显存和内存的程序,打开Tiled Decode,并从30秒测试;仍失败时,再考虑INT8主模型。本文没有正式测试INT8主模型的速度和质量,因此不做对比结论。
歌词没有唱完
不要只把300秒继续改成360秒。先减少重复副歌、压缩Bridge、缩短长句,并为器乐和自然尾奏预留时间。
音频生成成功但不好听
生成成功只证明技术链路通过。旋律、咬字、歌词遵循、重复、音色稳定和结尾,仍然需要从头到尾人工试听。
11 这套工作流适合谁
适合:
- 有NVIDIA显卡,愿意搭建本地ComfyUI环境;
- 希望反复生成原创歌曲,不想按次调用在线服务;
- 愿意自己写主题、修改Caption和控制歌词长度;
- 能接受长歌曲同时占用大量显存和系统内存。
不太适合:
- 只想打开网页立即出歌,不想处理模型下载和环境更新;
- 电脑只有很少系统内存,或磁盘空间紧张;
- 以为一次生成就必然旋律、歌词和结构全部满意;
- 需要直接用于商业发行,却没有继续处理版权、授权、混音和平台标识问题。
本文只验证了当前电脑、当前版本和5次正式生成。没有测试INT8主模型、其他显卡、16GB系统内存、批量并发和长期稳定运行。
12 我最终留下的AI写歌流程
- 先确定歌曲解决什么表达问题;
- 确定时长、BPM、风格和情绪曲线;
- 用Global Metadata、Vocal Details、Arrangement写Caption;
- 按目标时长设计歌词结构;
- 先跑30秒确认环境;
- 再生成完整歌曲;
- 从头试听歌词、错音、重复、结构和结尾;
- 发现没唱完,优先减歌词,不盲目加时长;
- 保存Caption、歌词、Seed、耗时和成品。
 看原图
官方工作流、模型下载脚本、完整提示词与歌词模板都在文末下载区,两首实测歌曲可以直接在下面试听。模型文件体积较大,请从官方仓库下载并自行核对。
官方资料:MiniMax Music 3官方介绍、MiniMax Music 3 GitHub仓库、Comfy-Org模型仓库和ComfyUI官方工作流模板。发布或商用前,请再次核对对应仓库的最新许可与平台规则。
智能搭子 · 和你一起把AI真正用起来 · 真实体验 · 客观判断 · 持续探索
下载本文文件
工作流是 ComfyUI 官方模板原样留档。下载脚本里的 local_dir 要改成你自己的 ComfyUI models 目录。
模型清单
只给官方下载页,本站不转存模型。按完整文件名选择,不用下载整个仓库。
MiniMax Music 3(12GB 显卡组合)3 个文件,约 13.35GiB
阿洁提醒:长歌曲同时吃显存和系统内存。我这台是 12GB 显卡配 32GB 内存,五分钟歌曲时还用到了约 11GB 共享 GPU 内存。
测试环境
生成耗时从任务开始算到文件保存。
- 显卡
- RTX 5070 12GB
- 内存
- 32GB
- ComfyUI 核心
- 0.33.0
- PyTorch
- 2.13.0+cu130
- 5 分钟歌曲
- 约 9–10.5 分钟
- 实测日期
- 2026-08
来源与使用范围
用到的素材和工具来自不同作者,使用前请看清各自的范围。
可以这样用
工作流来自 ComfyUI 官方模板库(MIT 许可),可以导入、修改;提示词和歌词模板随便改成自己的歌。
不要这样用
没核对模型许可和平台规则,就把生成歌曲用于商业发行;把本页两首试听歌曲下载下来另作他用。
模型:MiniMax-AI/MiniMax-Music3;ComfyUI 权重:Comfy-Org/MiniMax-Music-3;工作流:Comfy-Org/workflow_templates。
写在最后
文中的结果都是我在自己电脑上实测的,换一台电脑、换个软件或模型版本,结果可能不一样。
模型和工具的版权归原作者,本站只链接官方下载地址;可下载的工作流和脚本按现状分享,运行前请先看一遍内容,重要文件先备份。
声音克隆、换脸换装、AI 生成的图片、视频和音乐,请只用你自己的或已经获得授权的素材,发布和使用时遵守法律法规和平台规则。
如有内容涉及侵权,请通过公众号「智能搭子」私信联系我,核实后会及时删除。