 智能搭子
PoseSwap怎么用?从一张人物图开始,换姿势、换衣服
本文附 3 份工作流和 1 个安装脚本导入 ComfyUI 就能用;模型清单和官方下载地址也在文末。
去下载大家好,我是你的智能搭子阿洁。
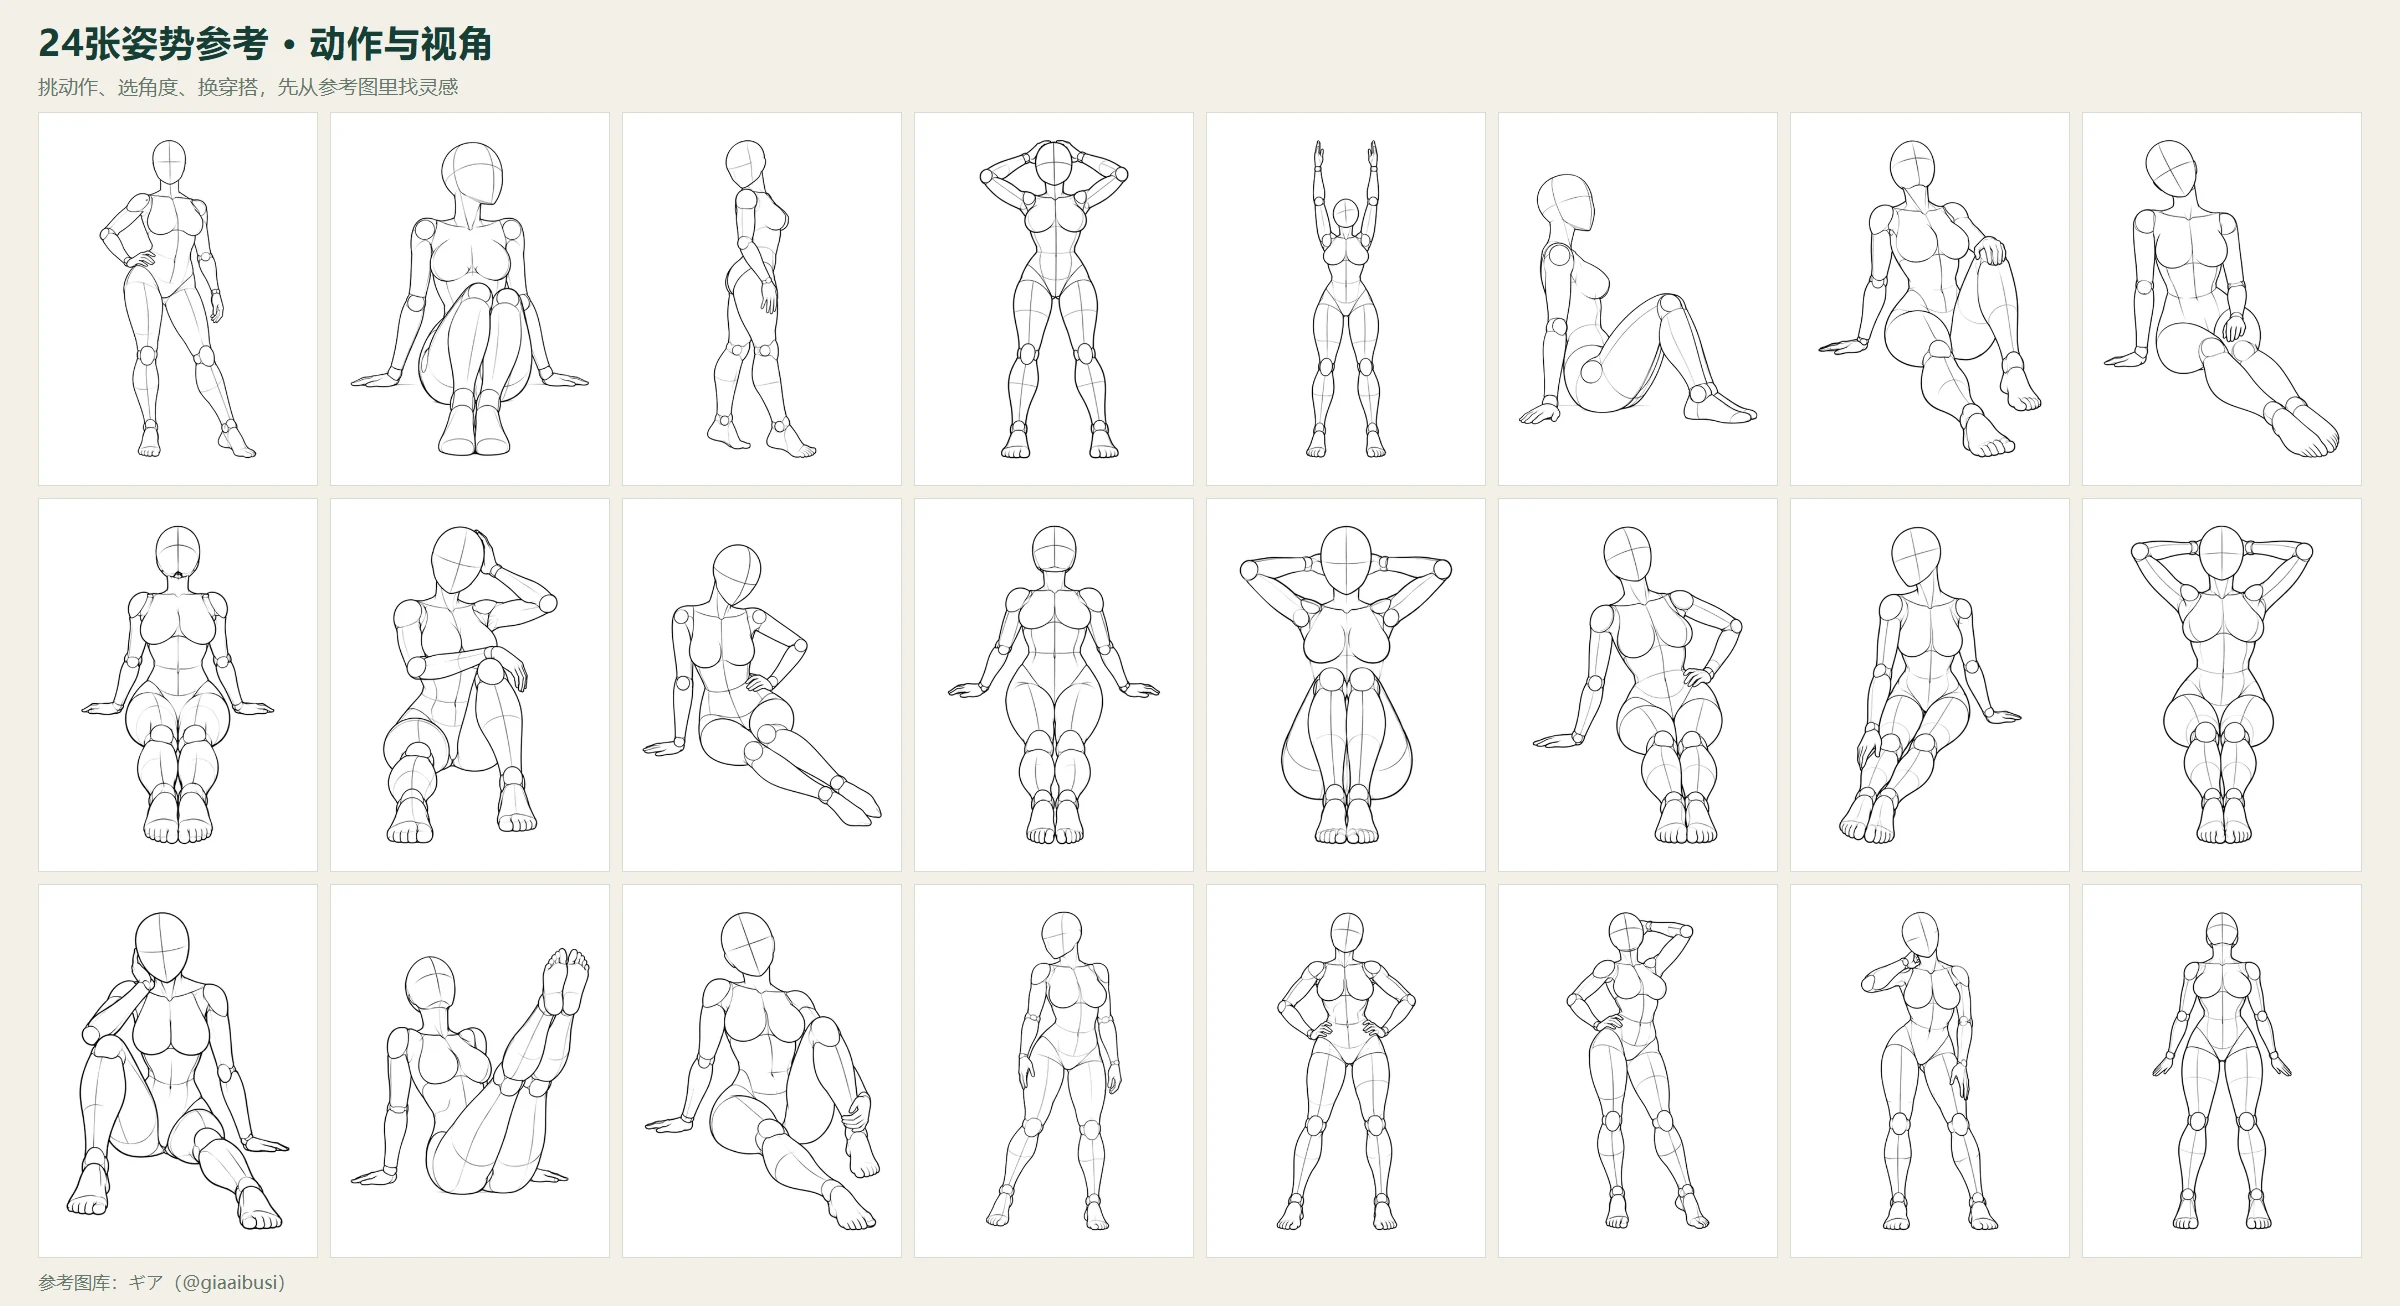
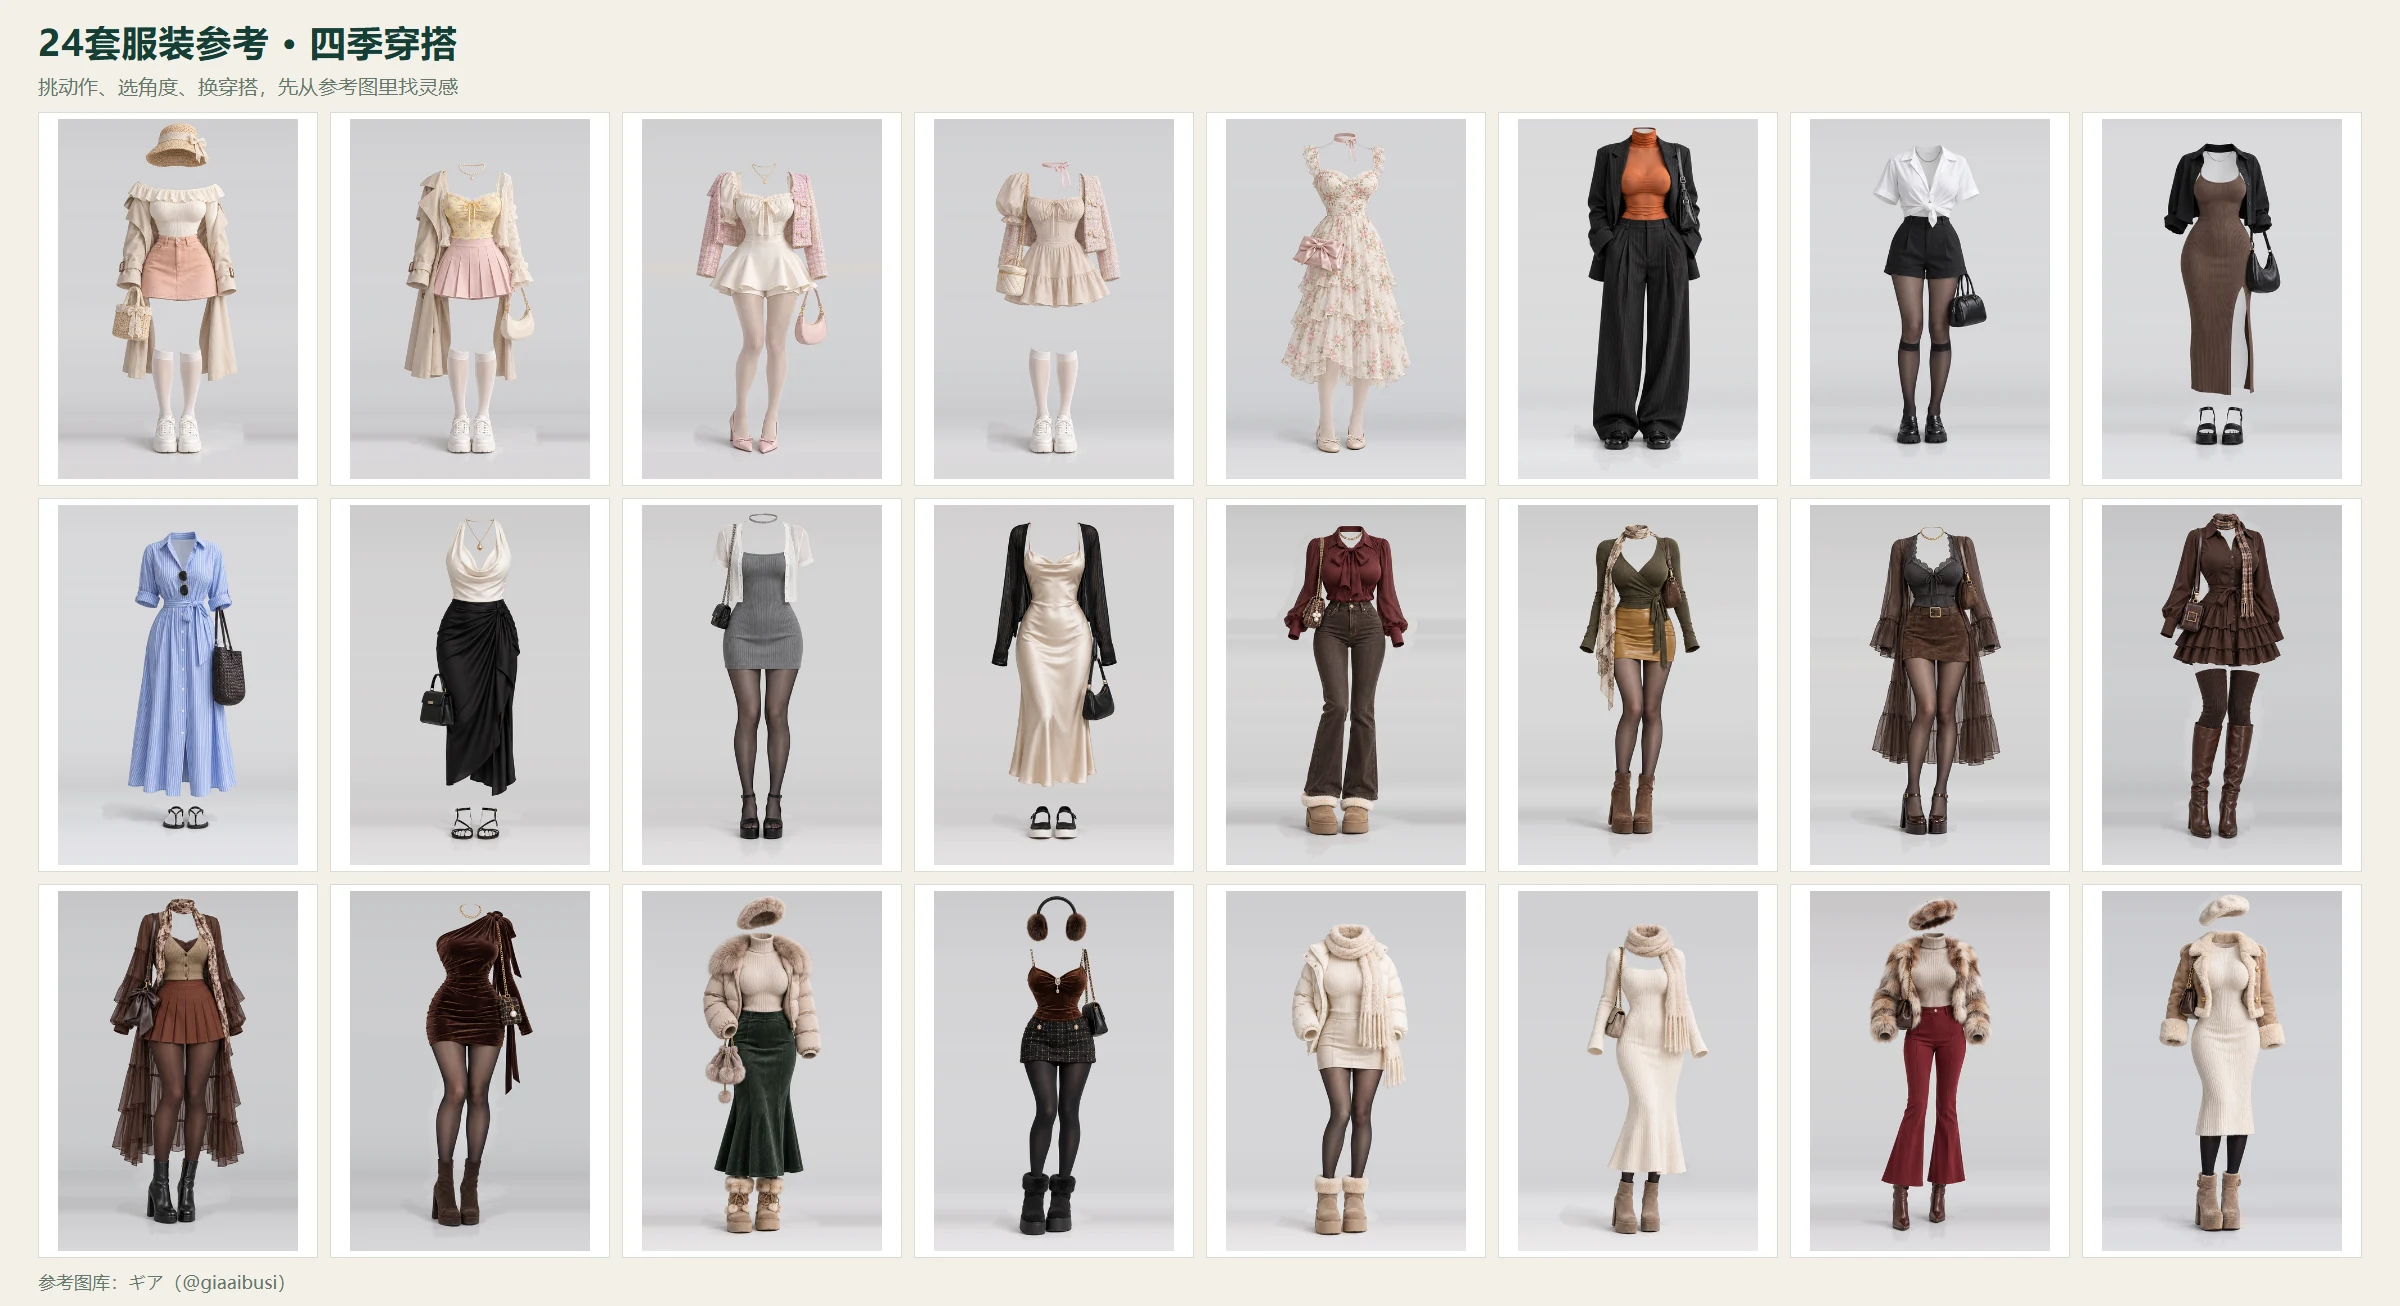
最近,AI绘图圈有套挺火的人物参考图库:1439张姿势参考图,1407套服装参考图。 想让人物坐下、侧身,或换一身穿搭,可以先挑一张参考,不必把动作和衣服全靠文字描述。
相关的中文整理项目10月27日创建,截至11月1日已有4800多个GitHub Star。而我这次关注的PoseSwap,把上述规模的姿势、服装图库和生成流程接进了ComfyUI,做成换姿、换装节点。
其中1439张对应288组动作的多个视角,选同一动作时,还能比较正面、侧面、俯视等角度。
先放24张姿势参考:站立、坐下、侧身、抬手,同一类动作还能换角度挑。
 看原图
服装参考则把人物拿掉,留下衣服和搭配。下面24套覆盖春夏秋冬,这次换装用的碎花裙和条纹西装也在里面。
 看原图
PoseSwap做什么,图库又是谁的?
PoseSwap项目把选图和生成分成四个节点:姿势选择、换姿生成、服装选择、换装生成。插件负责组织操作,真正生成图片的是Qwen模型。 下载插件并不等于已经有了模型。
它适合两件事:让已有角色摆出另一种姿势;用服装参考图给人物试穿另一套穿搭。产出的是静态图,可以继续挑选为角色设定、分镜或视频生成的参考。它不会把一张图直接变成动作视频,也不保证连续编辑时脸、衣服和姿态完全不变。
这里有几层不同的贡献:
- 创作者ギア(@giaaibusi)公开了姿势线稿、深度姿势和服装参考等图库。
- 中文开发者做了汉化与功能扩展。nvzhuang增加了服装检索、试穿和模型接入,并鸣谢原作者。
- PoseSwap把这些操作做成了ComfyUI节点,换装做法参考了nvzhuang,姿势部分也用到了社区整理的中文图库。
原站允许逐张用于作品制作和生成参考,同时禁止图片本体再分发与整库批量下载。这次我只取需要的参考图,使用插件代码和“加载图像”节点,不搬运整套图库。线稿和深度图也要分清:本次换姿用线稿,深度控制没有测。
先准备换姿需要的四个模型文件
先把换姿跑通,再准备换装,可以少排查一半问题。本次换姿的文件与位置如下,路径从ComfyUI目录算起:
| 文件 | 放到哪里 |
|---|---|
| qwen_image_2.1_int8_convrot.safetensors | models/diffusion_models/ |
| qwen3vl_8b_int8_convrot.safetensors | models/text_encoders/ |
| qwen_image_2.1_vae_bf16.safetensors | models/vae/ |
| VNCCS_QI2_PoseStudioV1.1.safetensors | models/loras/ |
前三个在Comfy-Org的Qwen Image 2.1文件页,分别进入diffusion_models、text_encoders、vae目录,按表中完整文件名选择。姿态LoRA在PoseStudio文件页,这次选V1.1,先不要混用V2。
四个文件合计约17.44GB,其中LoRA约159MB;这是下载文件大小,不是运行显存。我的12GB显卡配合32GB内存实际完成了这轮测试,不能把它理解成全部权重都装进了显存。
插件README要求支持原生Qwen Image 2.1的核心,并标注0.43+。我这份核心自报0.37.0,但已经包含所需节点,本次实际跑通了。准备环境时,在节点搜索里查找TextEncodeQwenImage21和QwenImage21Cache:缺少时先在独立测试环境按核心更新说明处理,不要覆盖正在使用的工程。
装代码,再把第一张人物图接进去
我这次没有下载整套图库,只装了生成图片需要的插件代码。把这些文件放进ComfyUI,目录是这样:
ComfyUI/custom_nodes/comfyui-aicg3d-PoseSwap/
  __init__.py
  pose_data.py
  garment_data.py
  web/
    gallery.html
    garment_gallery.html
    pose_qwen21.js
    garment_qwen21.js
这些文件可以到项目页面里找到,逐个下载;也可以用配套的“安装PoseSwap代码.ps1”帮忙下载。它只下载上面的代码和说明文件,不下载模型或图库。电脑里已经装过这个插件的话,脚本会停下来,不会直接覆盖。使用时,把下面的路径改成自己包含main.py的ComfyUI目录:
.\安装PoseSwap代码.ps1 -ComfyRoot "D:\你的路径\ComfyUI"
装完后重启测试ComfyUI、刷新页面,搜索PoseQwen21或“AICG3D PoseSwap”。能找到“Qwen2.1姿态换姿生成”,再往下接图;若没有,先看启动终端是否有插件导入错误。
接下来只需要四个节点:
加载图像:人物 → person_image ┐
                            ├→ PoseQwen21 → 保存图像
加载图像:姿势 → pose_image  ┘
我准备了一张新生成的现代成年女性全身参考图:低马尾、蓝绿色瑜伽上衣和高腰长裤、赤脚,站在明亮的瑜伽室里,双手自然下垂、没有手持物。原图为1024×1536,由图像工具生成,不是真人照片。人物最好全身入镜、脸部清楚、四肢容易辨认;姿势先选简单的单人站姿,别一开始就用复杂遮挡。
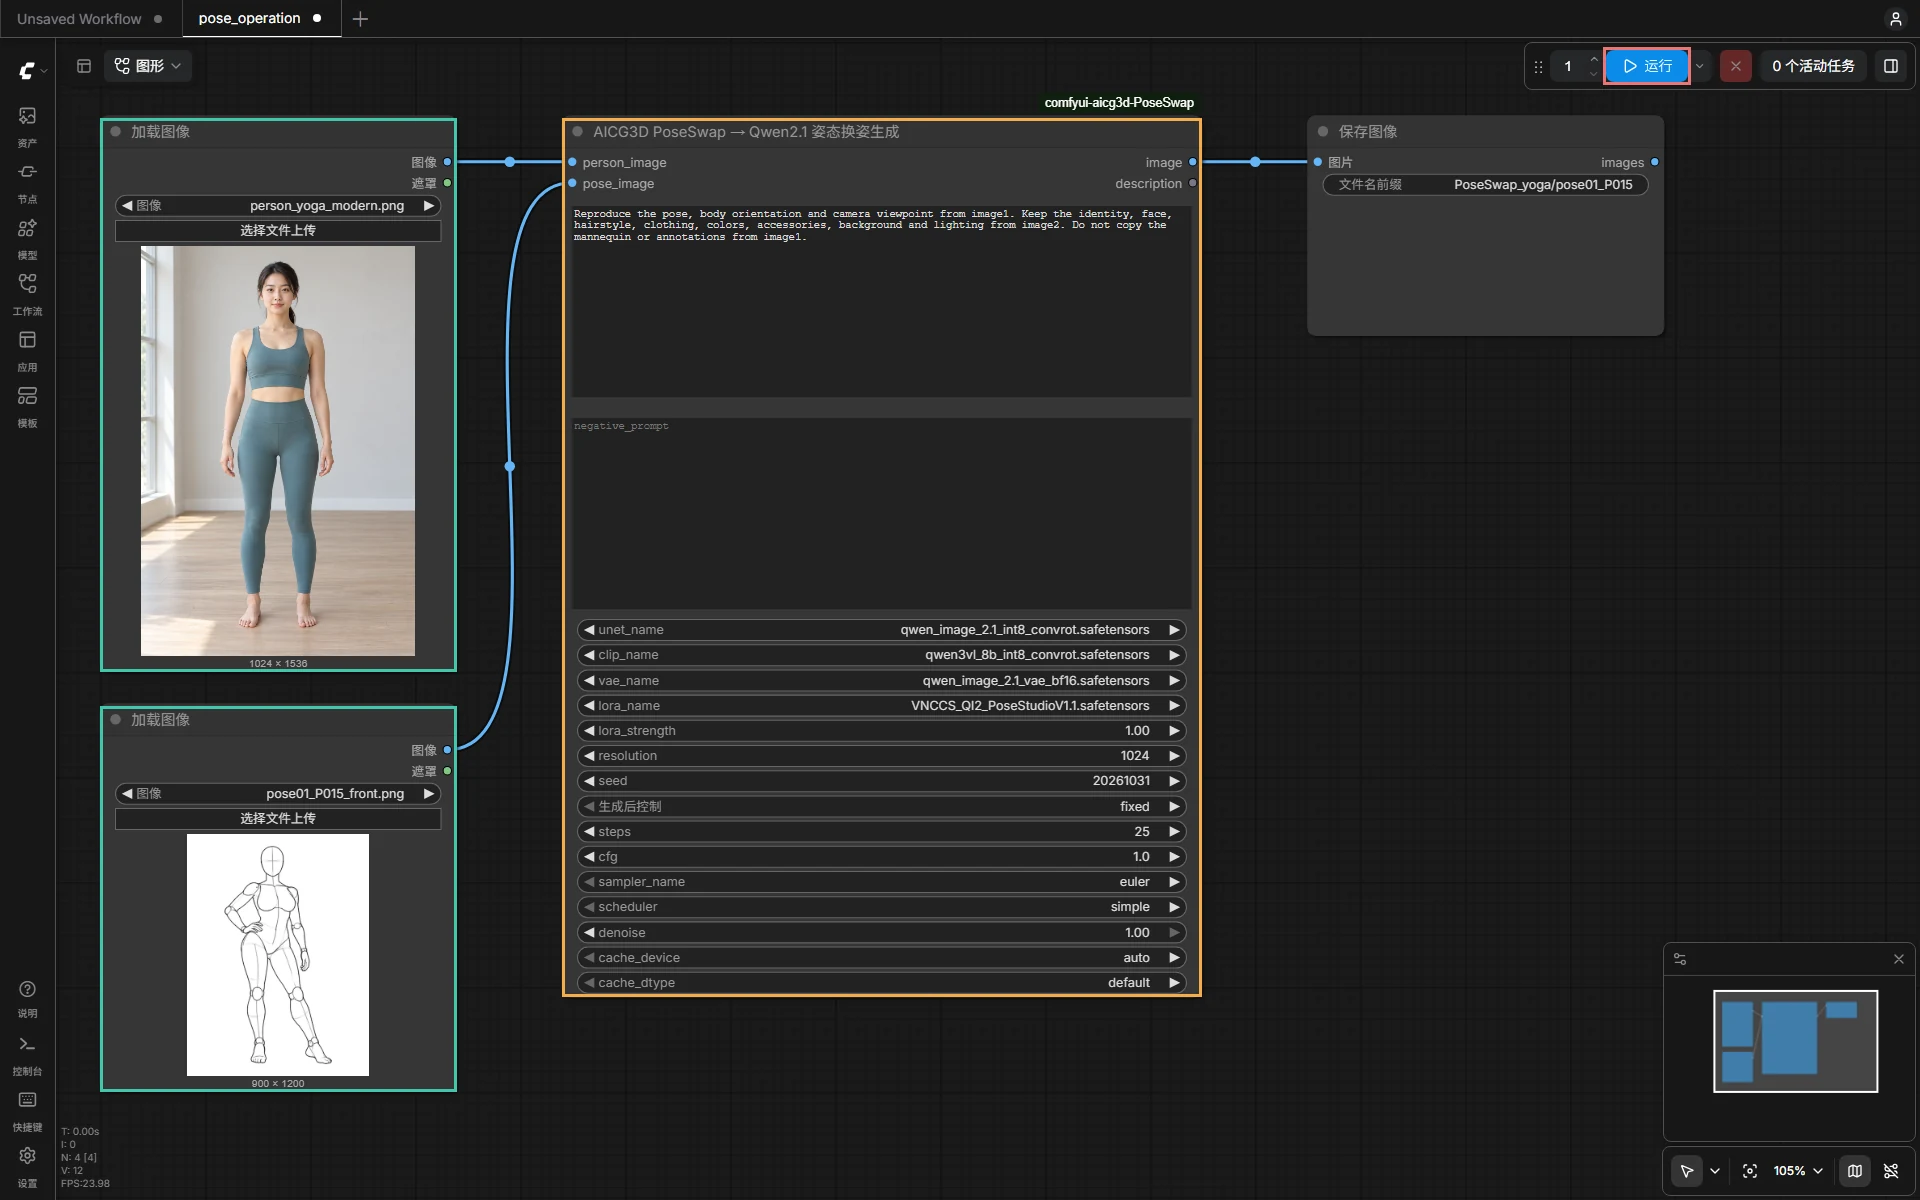
下面是加载换姿工作流后的实际界面:绿色方框是两张输入图,黄色方框是换姿生成节点,右上角红框是运行按钮。模型和参数都在中间的生成节点里。
 看原图
在第一个“加载图像”里上传人物,在第二个里上传从原站逐张选择的姿势线稿。两条线不要接反:person_image提供人物外貌,pose_image提供动作和视角。
在换姿节点里,依次从下拉框选中前面四个模型文件,设置:LoRA强度1、resolution 1024、25步、CFG 1、Euler/simple、denoise 1,cache保持auto/default。第一次照着做时,可以和我一样把种子填成20261031,再把“生成后控制”改成fixed,让它每次运行后都不变,方便只换姿势图来看差别。
本次使用的换姿提示词如下;正向框粘贴,负向框留空:
Reproduce the pose, body orientation and camera viewpoint from image1. Keep the identity, face, hairstyle, clothing, colors, accessories, background and lighting from image2. Do not copy the mannequin or annotations from image1.
点右上角“运行”。成功后,保存节点会输出图片,文件进入ComfyUI的output目录;本次前缀是PoseSwap_yoga/pose01_P015。先打开原图检查人物和动作,再继续换第二种姿势。
配套目录现在有换姿_可视化.json,已经在本机界面导入、导出后重新加载检查。也可以把它拖入画布,重新上传自己的两张图、核对模型下拉框后运行。文件名不同不会自动替你匹配模型。
 看原图
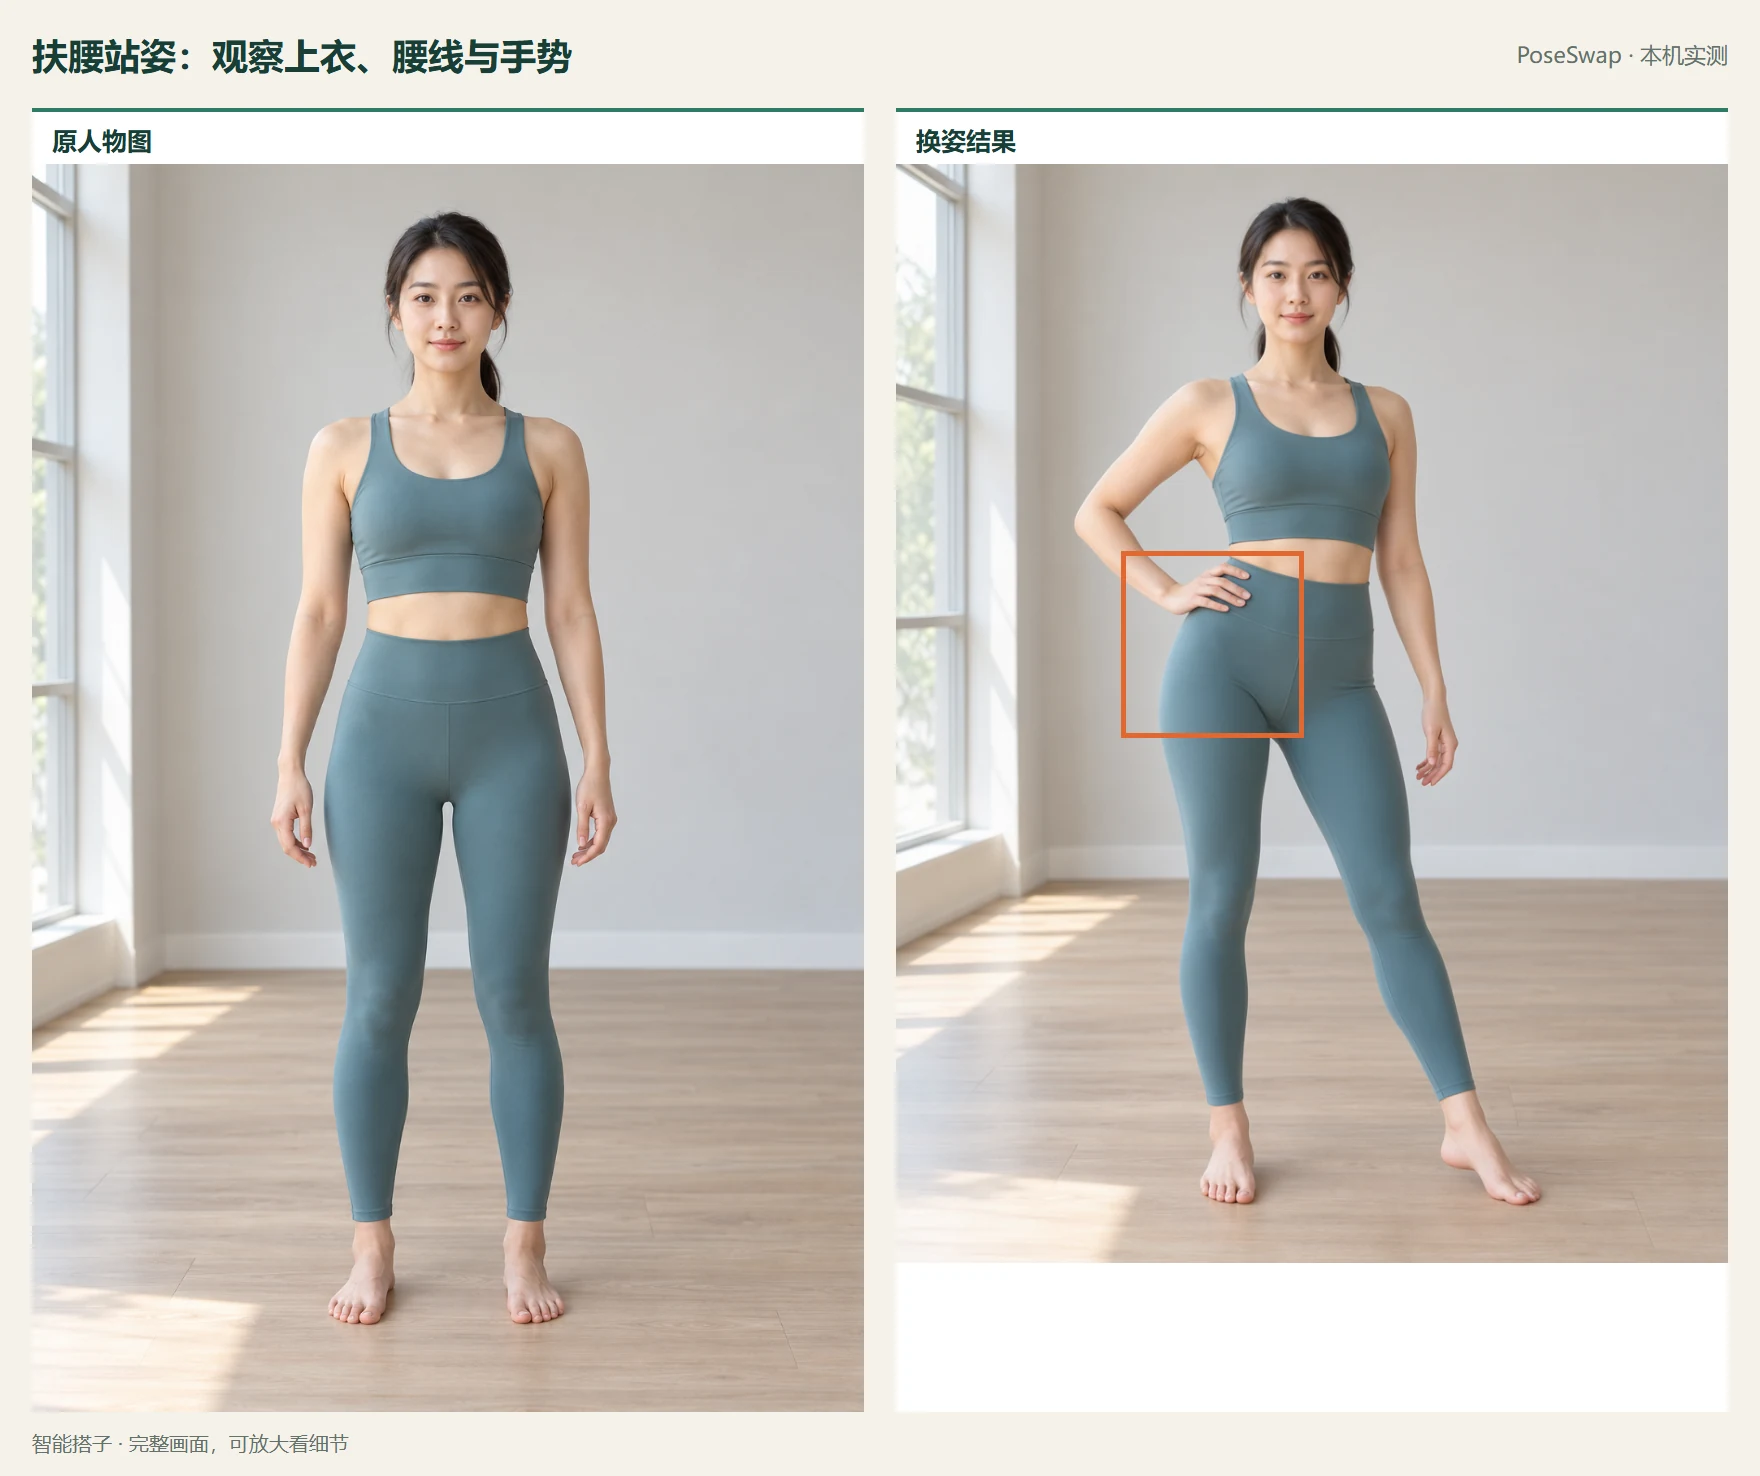
第一张扶腰站姿约35.3秒,输出896×1184。手抬到了腰侧,身体重心和双腿位置有了变化;蓝绿色上衣、高腰长裤和马尾仍在,窗户与木地板也大体延续下来。
这一步先看“动作有没有跟上”,再看“衣服有没有跟着改”。上衣下摆、腰线和手指的位置,都值得放大检查,不能仅凭同一种颜色判断服装完整保留。
换一个姿势,观察瑜伽服和身体朝向
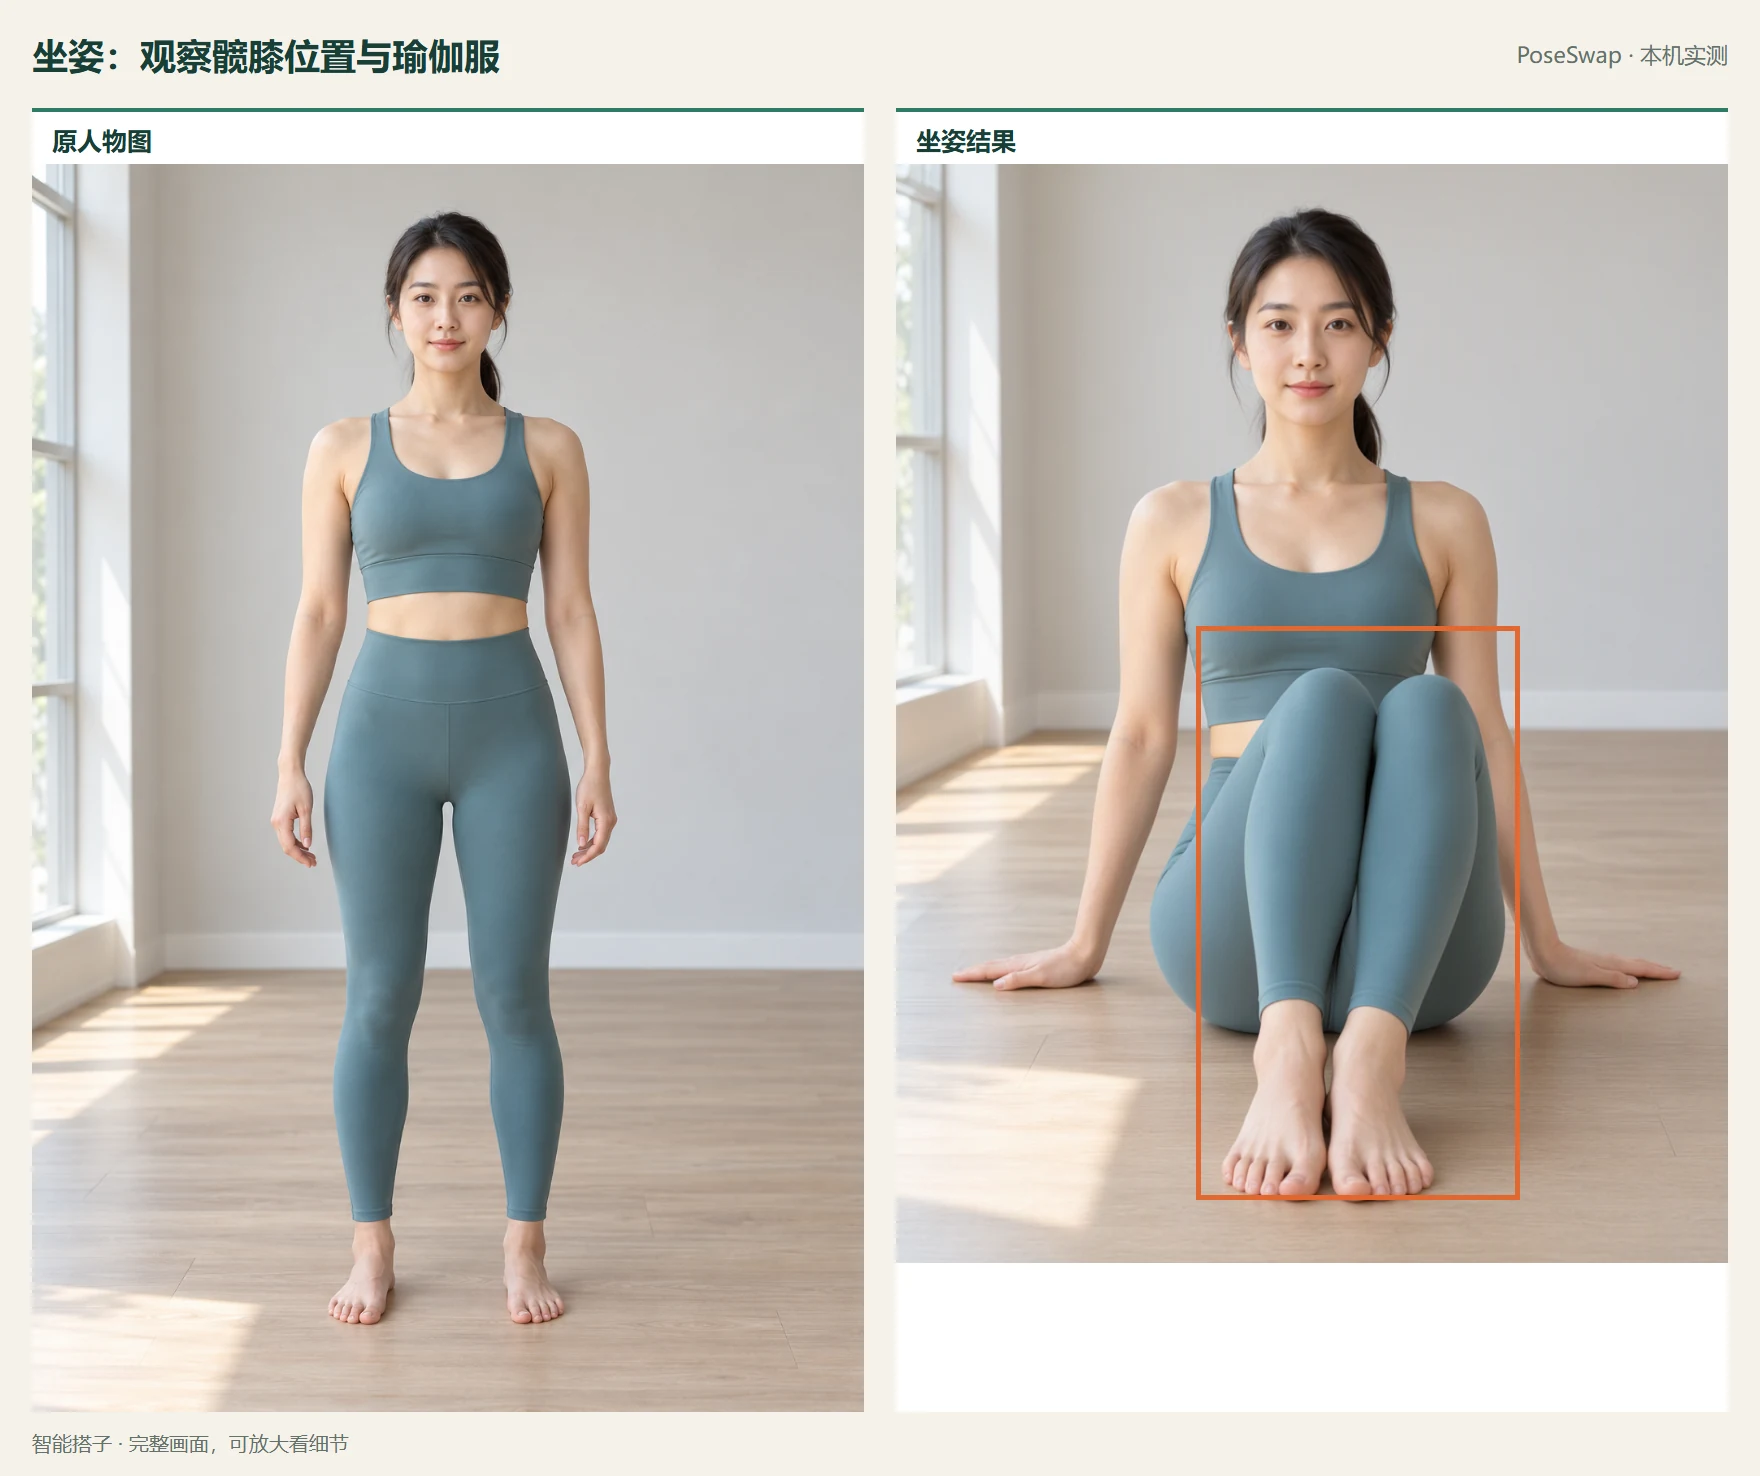
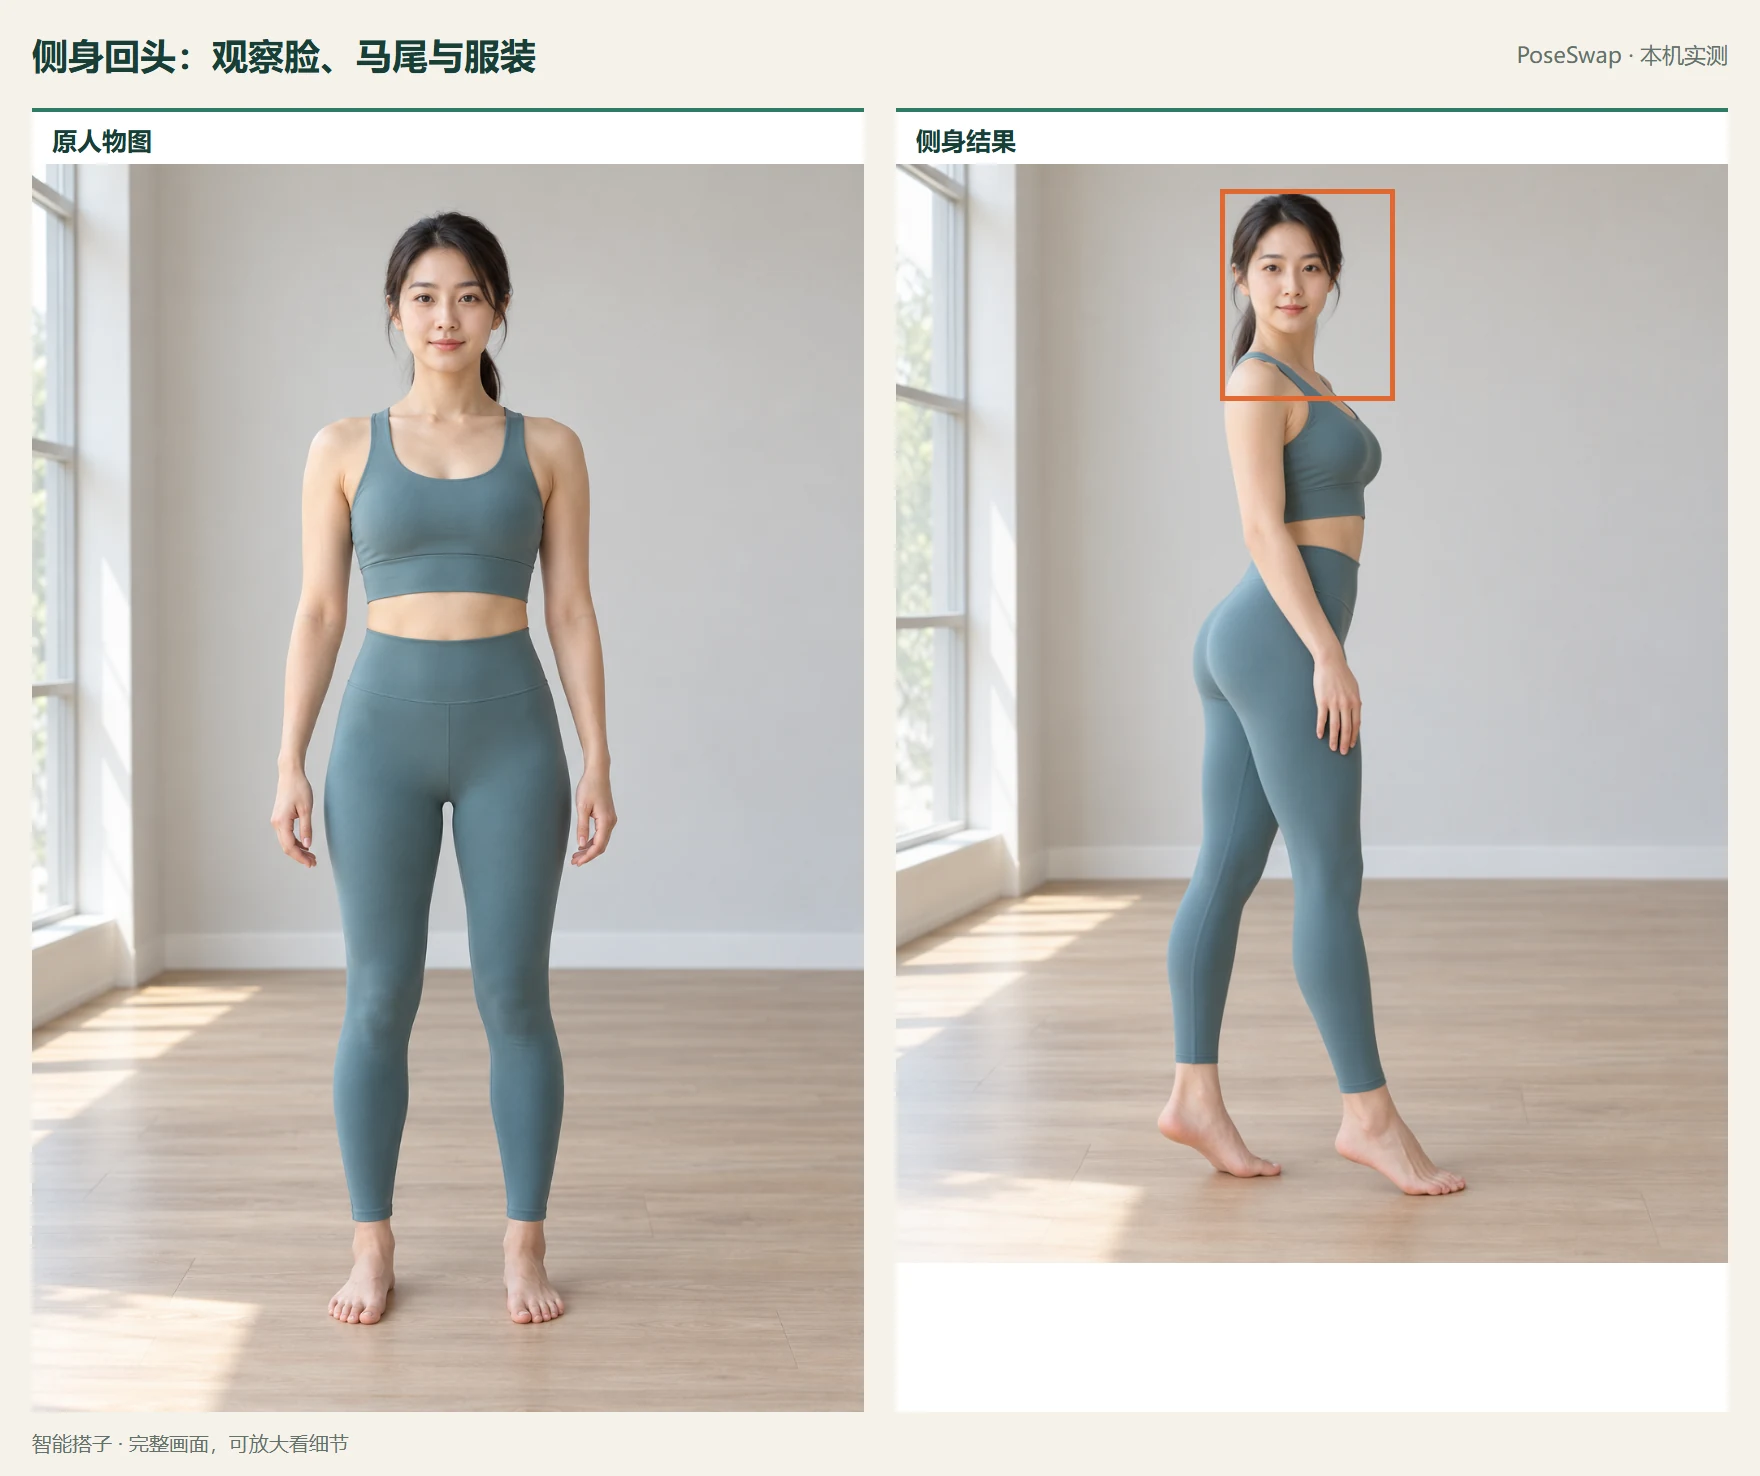
保持同一张人物图、同一组参数,只换姿势输入。我又试了坐姿和侧身回头,分别约33.3秒、33.4秒,输出都是896×1184。
 看原图
坐姿里,双膝并拢、双手撑地的关系出现了。瑜伽上衣与长裤的颜色、整体款式延续下来,膝部随坐下发生弯折。这套贴身服装便于观察髋、膝和手的位置,不必先隔着宽大的衣摆判断动作。
 看原图
侧身这张保留了马尾和瑜伽服,身体转向侧面、脸朝镜头。脚跟也被抬了起来。它做出了侧身效果,但精细的脚姿、脸部轮廓和服装接缝仍要对照原图看,不能理解为逐关节复制。
再接换装:GGUF要走另一份工作流
这一步需要另一套模型。Qwen Image 2.1的换姿权重,不等于Qwen-Image-Edit-2511的换装权重。 我复用了本机现有GGUF,因此用展开工作流,没有直接使用插件封装的原生换装加载器。
| 文件 | 放到哪里 |
|---|---|
| qwen-image-edit-2511-Q4_K_M.gguf | models/diffusion_models/ |
| qwen_2.5_vl_7b_fp8_scaled.safetensors | models/text_encoders/ |
| qwen_image_vae.safetensors | models/vae/ |
| Qwen-Image-Edit-2511-Lightning-4steps-V1.0-bf16.safetensors | models/loras/ |
下载入口分别是:Unsloth的2511 GGUF、Comfy-Org的编码器与VAE、LightX2V的4步LoRA。按表选择文件,不用下载整个仓库。四个文件约23.73GB,已有同名权重就不必重复下载。
GGUF还需要ComfyUI-GGUF插件。从ComfyUI-Manager按完整项目名安装,或按该仓库说明放到custom_nodes并用ComfyUI自己的Python安装其requirements,重启后搜索UnetLoaderGGUF确认。GGUF文件不能改个后缀,当作safetensors加载。
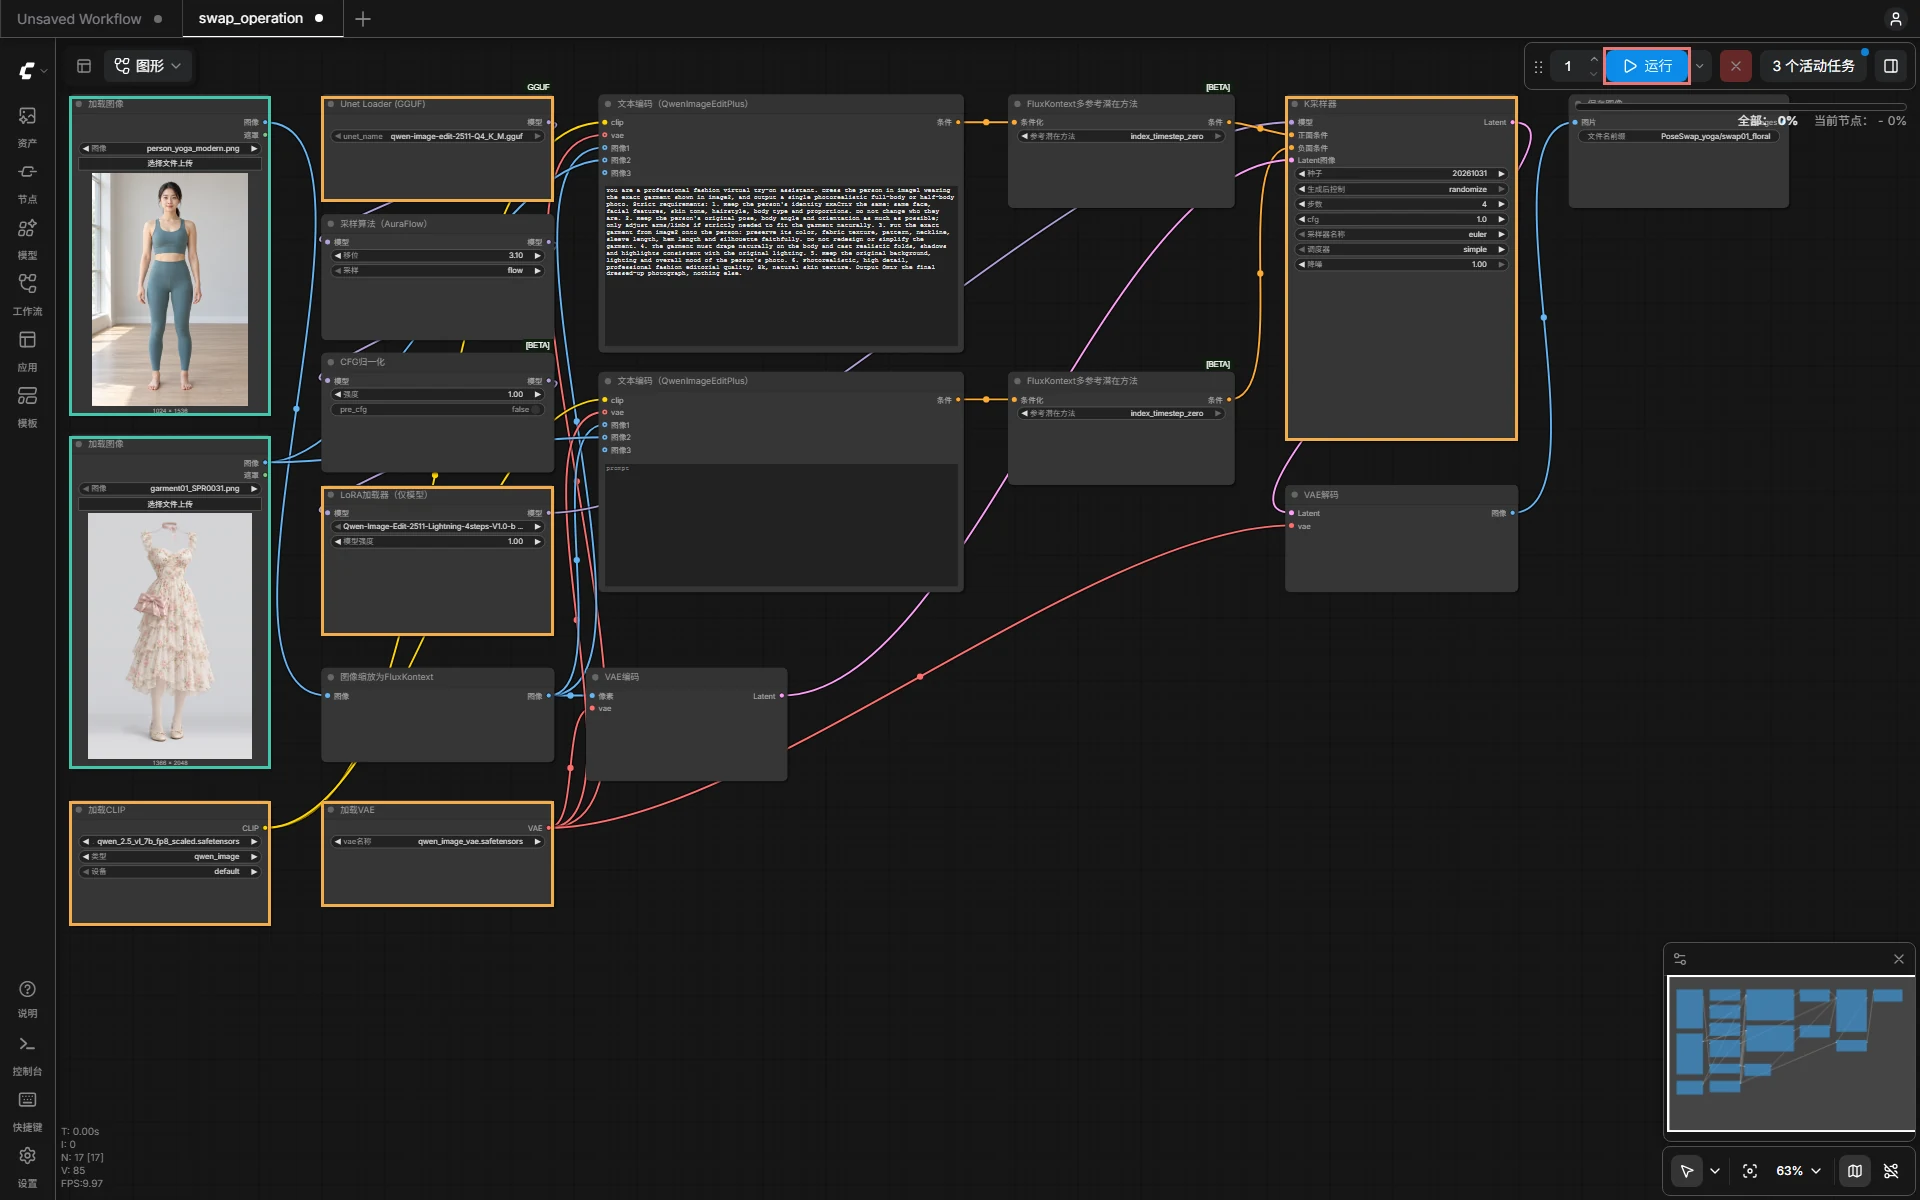
配套的换装_可视化.json已经在本机界面加载、导出并重新导入检查。导入后先做这四件事:
- 第一个“加载图像”上传原人物图,第二个上传服装图。先别接上一轮换姿结果,这样能单独观察换装。
- 在
UnetLoaderGGUF里选Q4_K_M文件;在CLIPLoader、VAELoader和LoRA加载器里分别选表中另三个文件。 - 保留工作流中的提示词和连线:人物接
image1,服装接image2;采样4步、CFG 1、Euler/simple,shift 3.1,LoRA强度1。 - 点“运行”,打开保存节点的完整结果,检查衣领、袖长、花纹、裤腿、鞋和脸,不只看衣服颜色。
下图是我在ComfyUI里加载的GGUF换装工作流。绿色方框里的第一张是人物、第二张是服装;黄色方框分别标出模型加载与采样设置,右上角红框是运行按钮。可以先放大核对文件名和连线,再运行。
 看原图
不使用配套JSON,也可以按下面的节点关系手工搭建展开版;正、负两路都保留人物和服装参考:
人物LoadImage → FluxKontextImageScale → VAEEncode → KSampler.latent_image
服装LoadImage ───────────────────────────┐
缩放后人物 ─────────────────────────────┤
CLIPLoader + VAELoader ──────────────────┤
  → TextEncodeQwenImageEditPlus(写换装要求)
  → FluxKontextMultiReferenceLatentMethod(index_timestep_zero)
  → KSampler.positive
同样两张图、同样CLIP和VAE → 另一份TextEncodeQwenImageEditPlus(空提示词)
  → 另一份FluxKontextMultiReferenceLatentMethod(index_timestep_zero)
  → KSampler.negative
UnetLoaderGGUF → ModelSamplingAuraFlow(flow,shift 3.1)
  → CFGNorm(strength 1,pre_cfg false)
  → LoraLoaderModelOnly(Lightning,strength 1)→ KSampler.model
KSampler → VAEDecode(接同一VAE)→ SaveImage
换装正向要求可以写成:“让image1中的人物穿上image2的服装,保留人物身份、发型、原姿势与背景;按服装参考保留颜色、面料、花纹、领口、袖长和轮廓,自然垂坠,只输出成图。”这是便于手工搭建的中文起点;本次六张实测中的换装,实际使用的是配套JSON里保留的插件英文默认全文。
 看原图
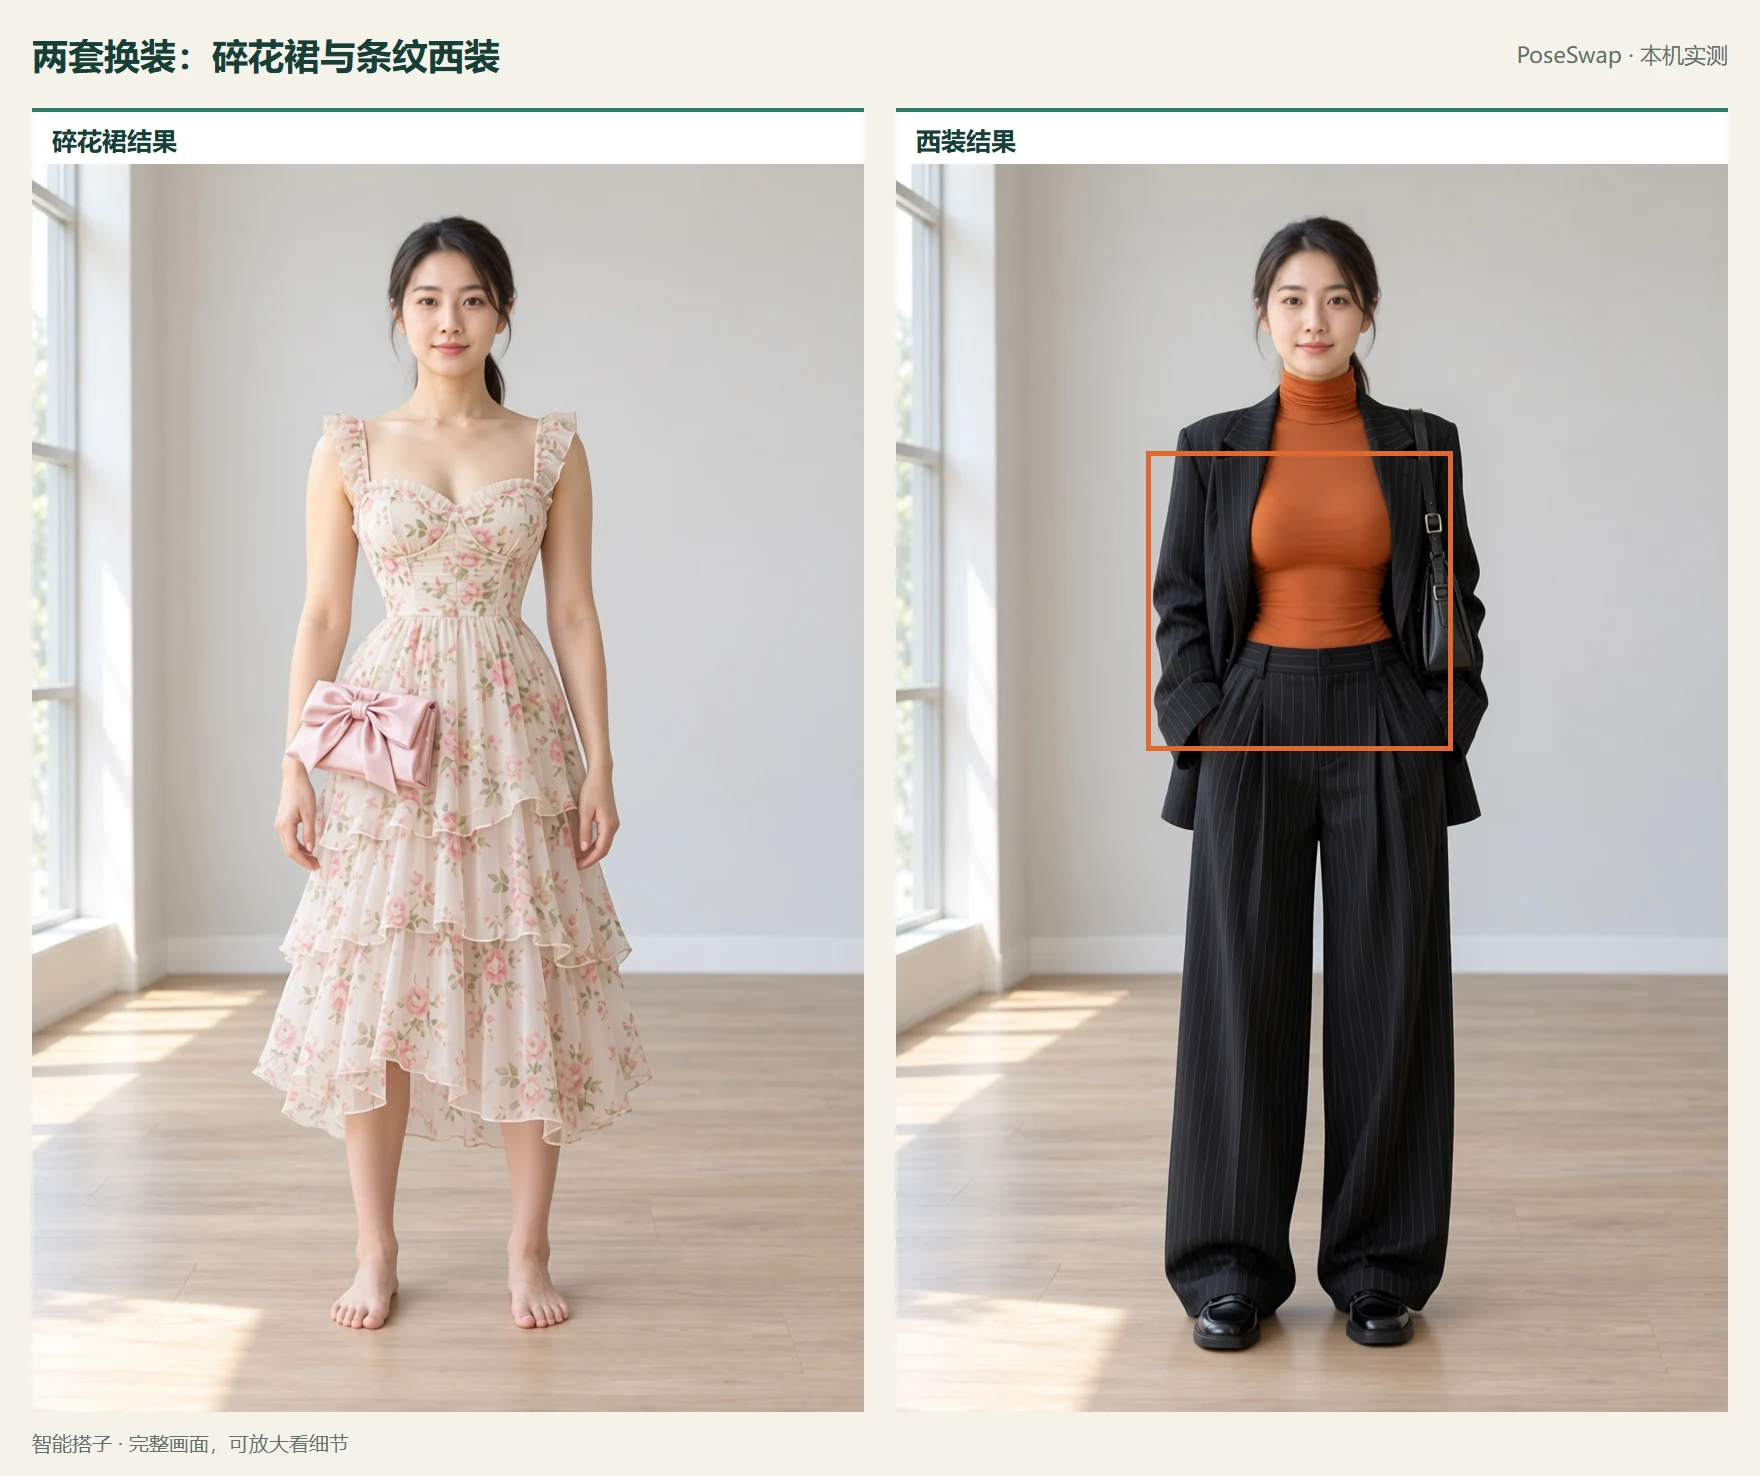
我从最初的瑜伽服正面图分别试了碎花裙与橙色高领配黑色条纹西装,约63.5秒、55.3秒,输出832×1248。
碎花、肩带荷叶边、裙身褶边和蝴蝶结包都出现了,原来赤脚的状态却留了下来,参考中的鞋和颈部丝带没有一起穿上。它采用了主要裙装特征,没有完整复制整套搭配。
西装这张出现了橙色高领、黑色条纹外套和阔腿裤、黑鞋与肩包,但原来垂下的双手变成了插袋。换装时,模型也会调整姿势;想把手势严格保住,还需要继续核对。
接在一起,点一次运行就能先换姿、再换装
换姿和换装可以放在同一张画布里,不用先保存图片、再手动上传。 准备好人物图、姿势图和服装图,点一次“运行”,工作流就会先换姿,再把结果送去换装。
如果用PoseSwap原版的封装节点,把“姿态换姿生成”的image输出,直接接到“换装生成”的person_image输入,服装图接garment_image,并把换装开关enable打开就行。关闭这个开关时,只输出换姿后的图片。
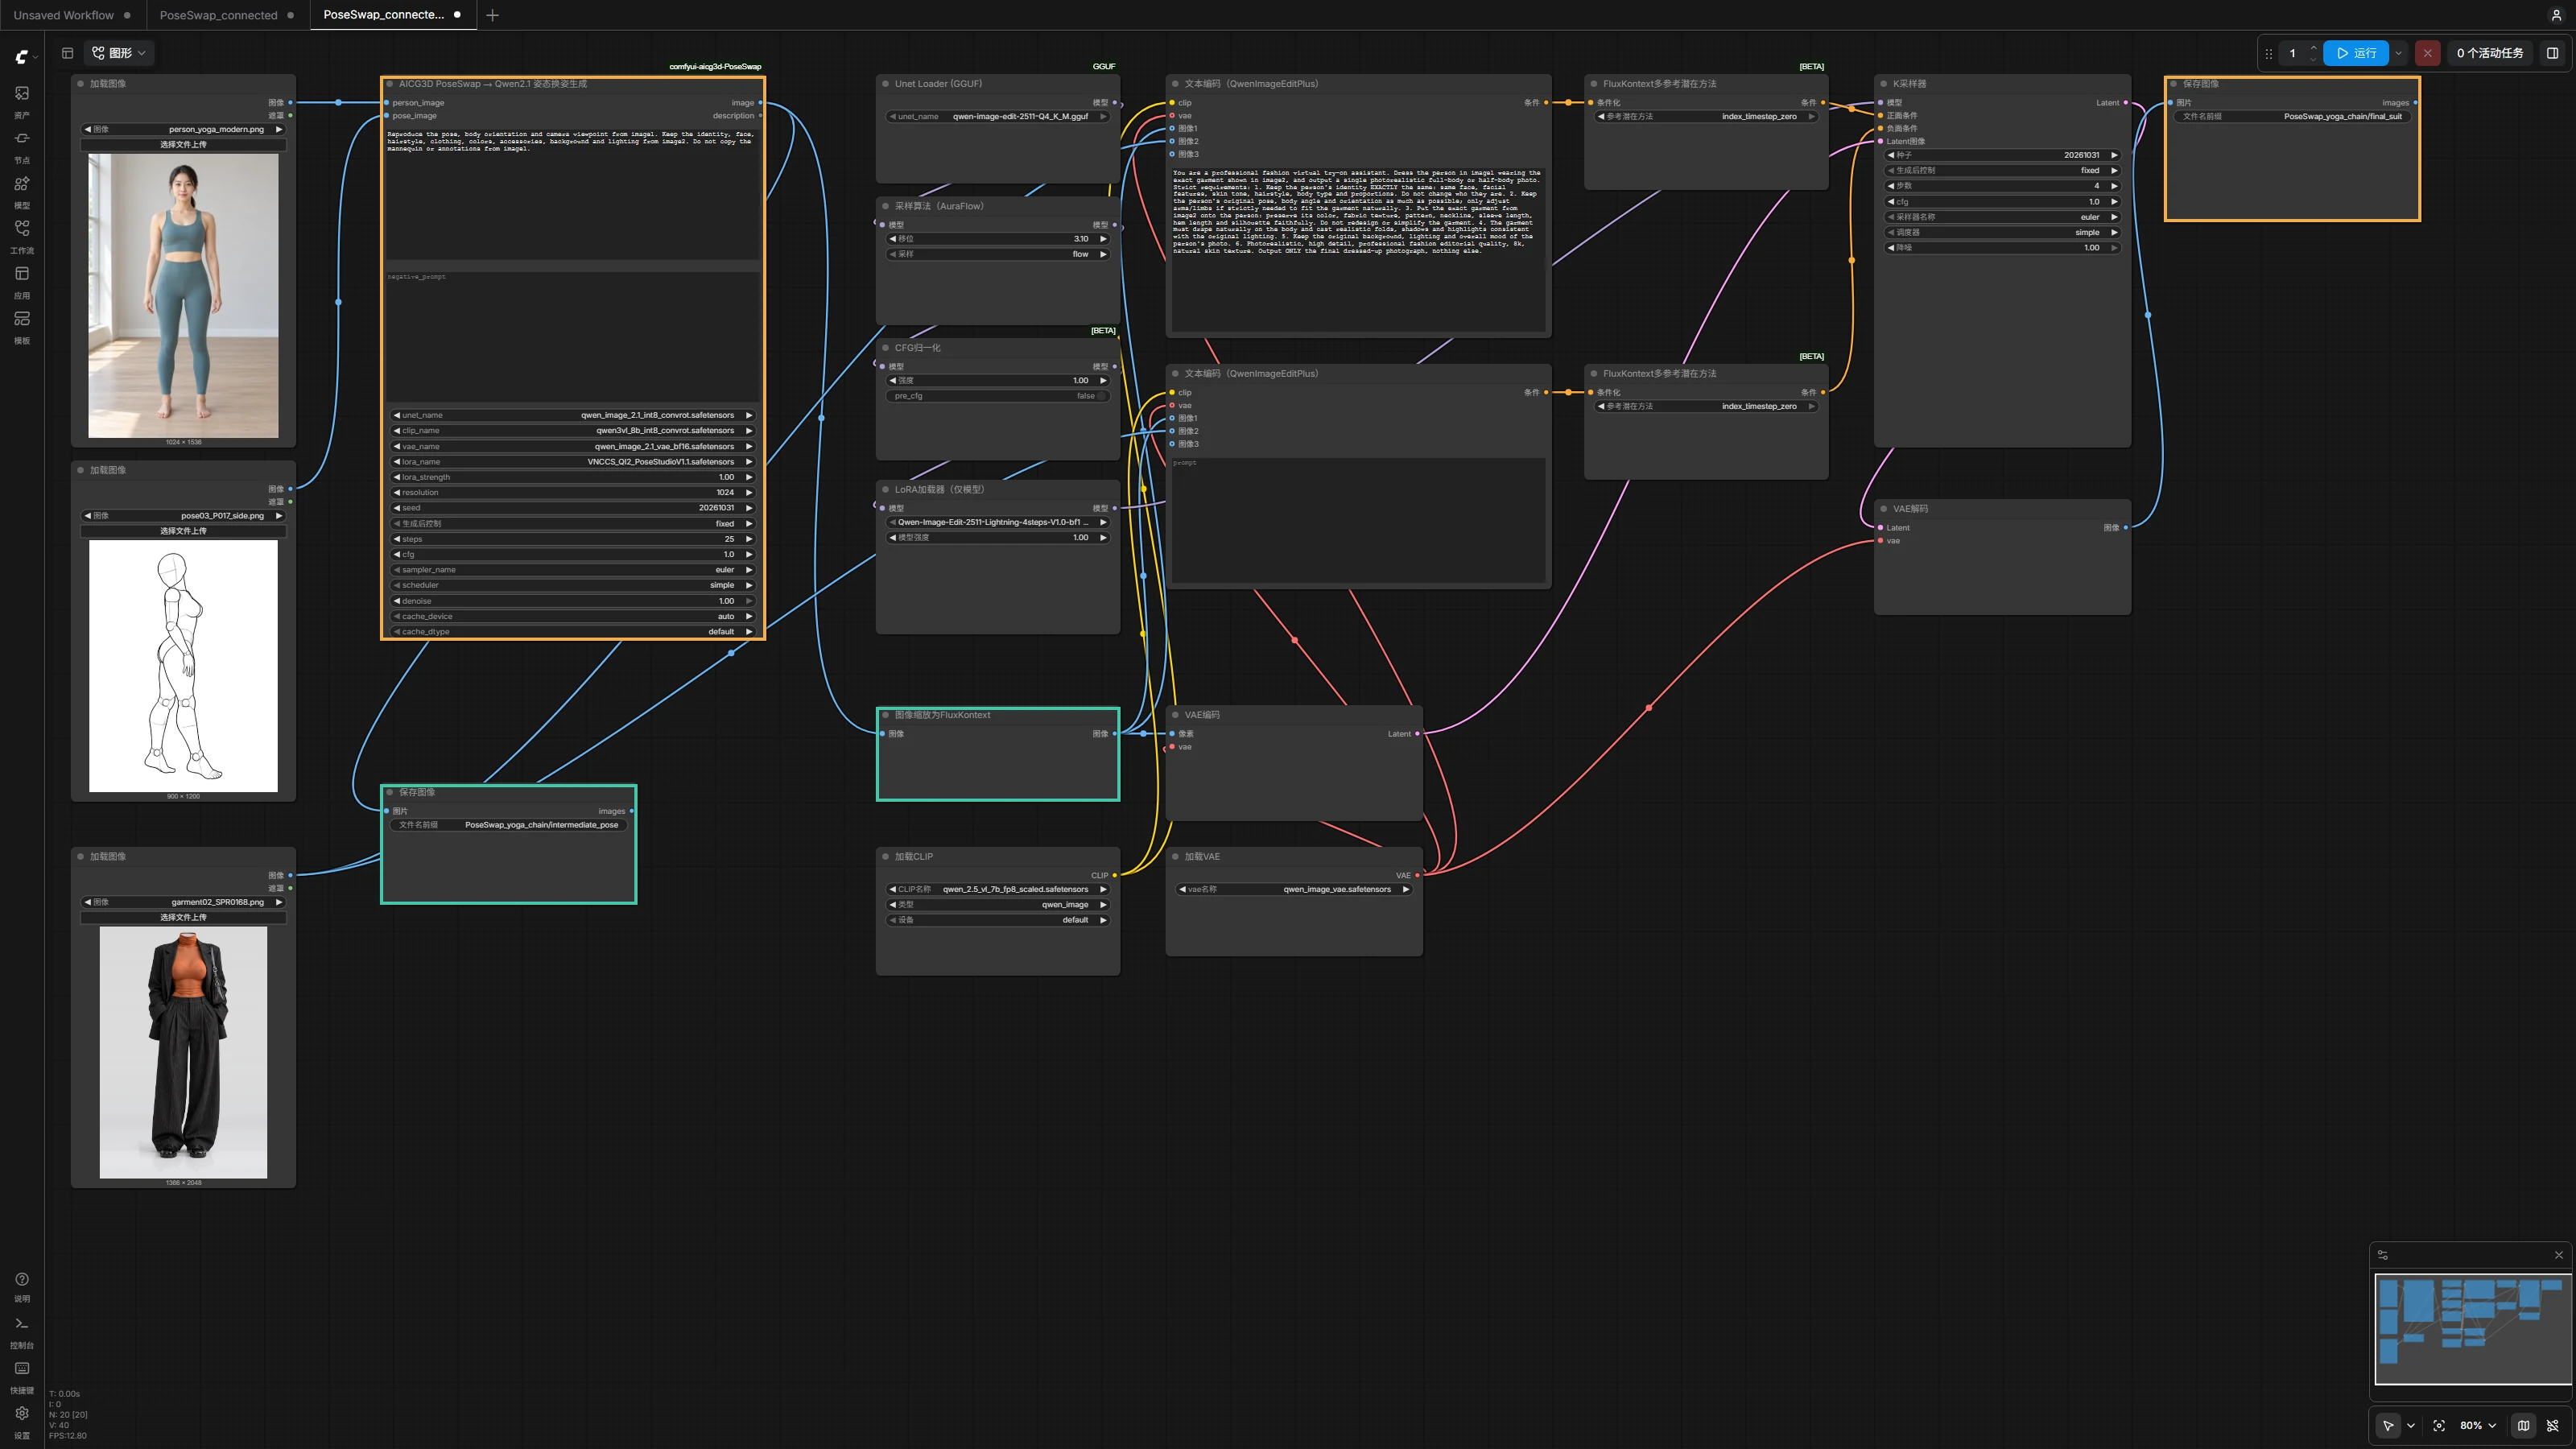
我这次使用GGUF展开版,接法稍有不同:把换姿结果直接接到换装流程最前面的FluxKontextImageScale,替代原先加载人物图的那条线。后面的编码、采样和保存照旧。
下面是接在同一张画布里的实际界面。左侧黄色框是换姿节点,它的图片输出接到中间绿色框里的缩放节点,再进入换装。左下绿色框顺手保存换姿中间图,最右黄色框保存最后的换装结果。
 看原图
配套的一键换姿换装_可视化.json也已接好。使用前,在同一个ComfyUI里装好PoseSwap和ComfyUI-GGUF,再上传人物、姿势和服装三张图,核对模型文件即可。
人物图+姿势图 → 换姿生成 → 换装流程的人物输入 → 保存最终结果
服装图 ─────────────────→ 换装流程的服装输入
点一次运行,里面仍然是先后做两次处理。我的六张实测为了分开检查效果,才先保存换姿图,再单独送去换装;这是测试时的做法,不是使用时必须多做的一步。
 看原图
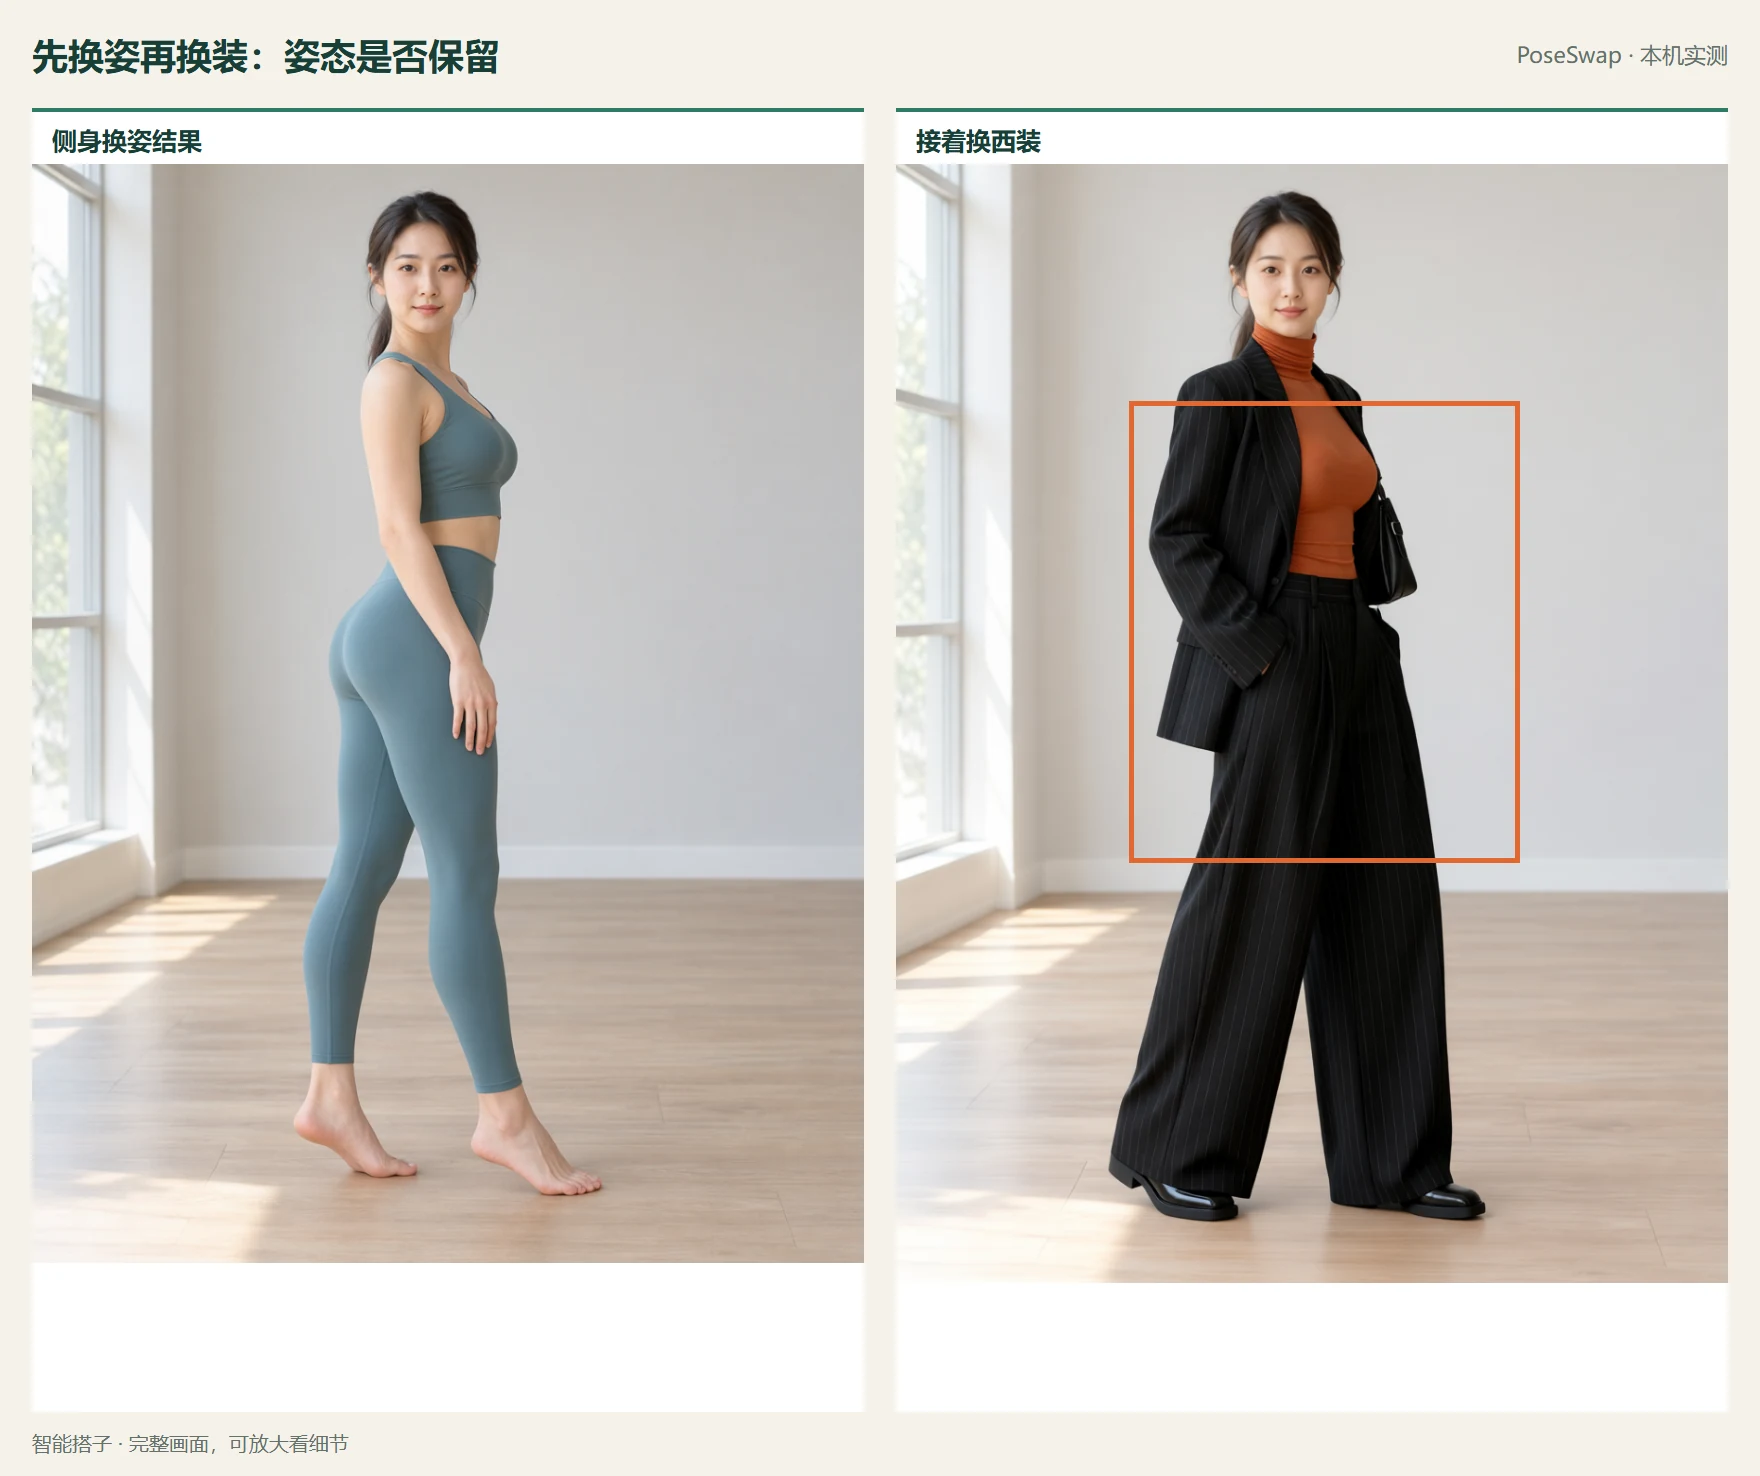
这次我把侧身瑜伽服结果送去换西装,换装这一步约54.0秒,输出880×1184。这个时间只算后一步,不是换姿加换装的总用时。
结果仍带侧身角度,衣服也换成了西装,但身体比输入更朝前,双手改成插袋。原来赤脚时抬起脚跟的姿态,换成皮鞋和宽裤腿后也不容易按原样确认。侧身轮廓部分留下了,姿态细节并没有完全保住。
想留住换姿后的图,也可以从换姿节点再拉一条线接“保存图像”,让它顺手存一份,不耽误后面自动换装。这样第二步如果改了想保留的姿态,还能拿中间图对照和调整。
卡住时,先查这几处
- 节点变红或提示缺节点:先看缺的是PoseSwap、GGUF,还是核心Qwen节点;分别处理,不需要为了一个缺项把全部插件重装。
- 模型下拉框没有文件:检查目录、完整文件名、文件是否下载完整;确认后刷新模型列表或重启。网页下载失败保存成HTML,也不能拿来当权重。
- 提示图库缺失:这份代码安装方式没有整库。用普通“加载图像”接生成节点,不使用姿势/服装选择节点;两种入口不能混着照抄。
- 显存不足:先只运行一条任务,关闭其他占显存生成,确认用了表中的量化版本。再尝试降低换姿resolution;换装还需检查人物输入经缩放后的尺寸。改变参数后需重新看质量,本次耗时不再适用。
- 出图了,但衣服、道具或方向改变:这属于生成结果变化,不能靠“任务成功”判合格。打开原人物、参考和结果逐项比较,决定保留、改提示词或重试。
文中的耗时,从每张图开始运行算到生成完成,包括中间加载模型和处理图片的时间,不包括提前下载模型、排队和启动软件的时间。电脑配置、模型版本不同,用时也会不一样。
有了喜欢的人物图,就可以拿它试不同的动作和穿搭,不用每次都从头生成人物。先挑出满意的几张,再拿去做角色设定或分镜参考。挑图时,除了脸像不像,也看看手势、衣服和身体朝向——换上了新衣服,不一定就保住了原来的动作。
智能搭子 · 和你一起把AI真正用起来 · 真实体验 · 客观判断 · 持续探索
下载本文文件
都在我的电脑上导入、导出、再导入检查过。导入后先核对模型下拉框,文件名不同不会自动匹配。
模型清单
只给官方下载页,本站不转存模型。按完整文件名选择,不用下载整个仓库。
换姿4 个文件,约 17.44GB
换装(GGUF)4 个文件,约 23.73GB · 另需 ComfyUI-GGUF 插件
阿洁提醒:上面的大小是下载大小,不是显存占用。我的 12GB 显卡配 32GB 内存跑通了这一轮。
测试环境
耗时从每张图开始运行算到生成完成,不含下载模型、排队和启动软件。
- 显卡
- RTX 5070 12GB
- 内存
- 32GB
- ComfyUI 核心
- 0.37.0
- 换姿一张
- 约 33–35 秒
- 换装一张
- 约 54–64 秒
- 实测日期
- 2026-11-01
来源与使用范围
用到的素材和工具来自不同作者,使用前请看清各自的范围。
可以这样用
参考图逐张用于作品制作和生成参考;本文的工作流可以自由导入、修改。
不要这样用
再分发参考图本体、批量下载整个图库。本站不打包图库,也不转存模型。
参考图库原作者:ギア(@giaaibusi)。插件:JGRFW/comfyui-aicg3d-PoseSwap,换装做法参考 paipiange/nvzhuang,中文图库整理 anhao/ai-pose-gallery-zh。
写在最后
文中的结果都是我在自己电脑上实测的,换一台电脑、换个软件或模型版本,结果可能不一样。
模型和工具的版权归原作者,本站只链接官方下载地址;可下载的工作流和脚本按现状分享,运行前请先看一遍内容,重要文件先备份。
声音克隆、换脸换装、AI 生成的图片、视频和音乐,请只用你自己的或已经获得授权的素材,发布和使用时遵守法律法规和平台规则。
如有内容涉及侵权,请通过公众号「智能搭子」私信联系我,核实后会及时删除。