 智能搭子
在ComfyUI里训练音色、给歌曲换声,我试完发现两件事
大家好,我是你的智能搭子阿洁。
这次我在ComfyUI里做了件和视频画面无关、但做视频时又用得上的事:训练音色,再给已有的录音和歌曲换声音。
流程确实跑通了。但听完结果,我觉得需要把两件事分开讲:训练成功,和声音好听,是两回事。
我用短录音训练的版本,杂音还是比较多;换成下载好的社区音色,同一段台词里,“男声·青年”听起来比较好。歌曲也做出了一个我觉得还行的版本。
这篇就把怎么做、哪里卡住,以及它和之前Qwen声音克隆的区别一起说清楚。
先弄明白:这是给录音换声,不是输入文字配音
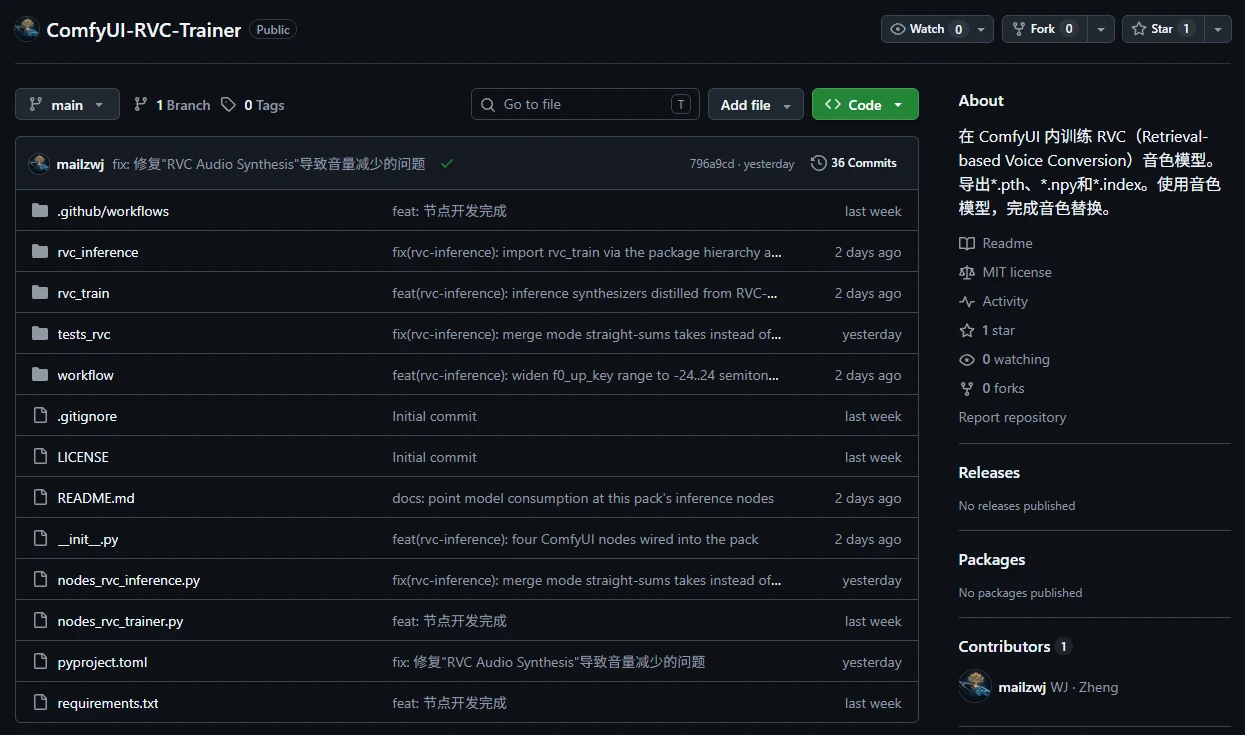
这次用的项目叫 ComfyUI-RVC-Trainer。它把音色训练和RVC音色转换做成了ComfyUI节点:可以准备音频、训练模型,再把模型加载回来换声。
 看原图
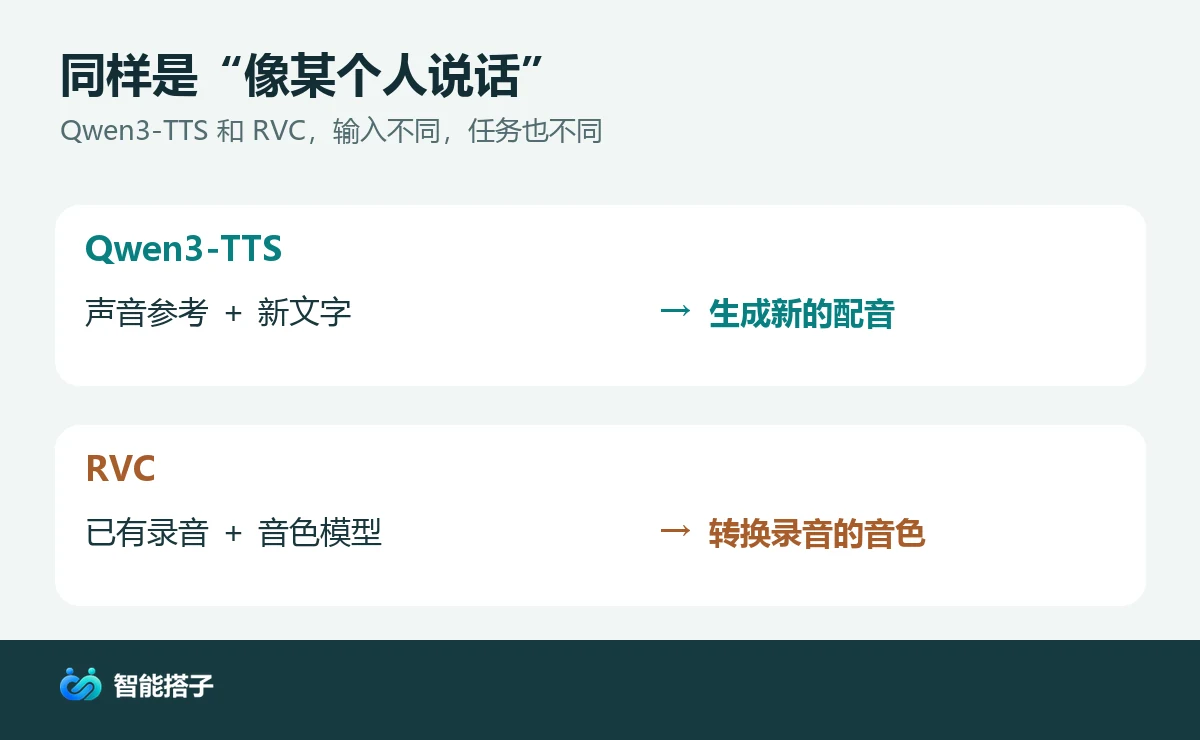
之前我测过Qwen3-TTS声音克隆。给一段参考声音,再输入想说的新文字,它会生成配音。那次用约17秒参考录音做ICL克隆,试听感觉相似度较高、语速也比较自然。
RVC这次的用法不同:先有一段说话或唱歌的音频,再把它转换成目标音色。 内容、节奏和表演主要来自原录音,转换后能保留多少,仍要听实际结果。
比如做旁白:只有文稿,想直接生成声音,我会先考虑Qwen;已经录好了语气和停顿,只想换个音色,就可以试RVC。歌曲的人声转换,也是后一种任务。
 看原图
训练能完成,但短录音没有让我得到满意的音色
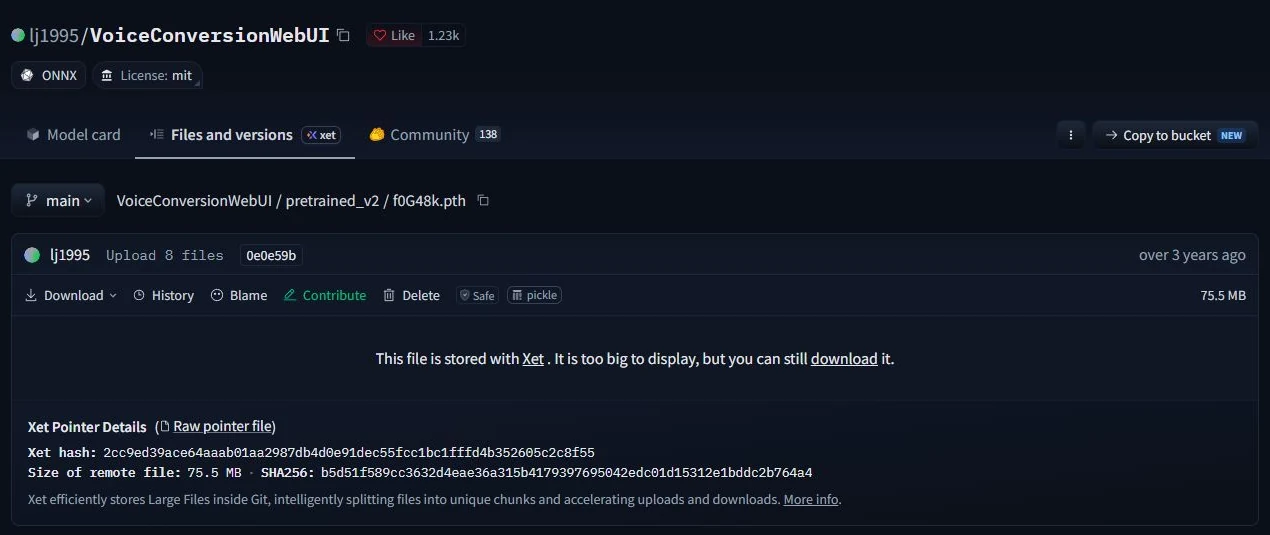
安装插件后,需要准备HuBERT、RMVPE,以及和训练设置匹配的预训练底座。我这一轮选的是 v2、48k、RMVPE,底座是pretrained_v2里的f0G48k.pth。
这里容易混淆:下载的f0G48k是训练底座,不是已经可以拿来换声的某个人物音色。自己的音色,要通过训练另外导出。
 看原图
训练画布很短,主要就是三个节点:准备数据集、训练模型、保存日志。
我的首轮素材约27.5秒,设置50轮、batch size为2、学习率0.0001,包含预处理和保存,任务用时约2分35秒,导出了音色模型和检索向量。后面又换了素材继续试,其中一版约17.4秒,仍然属于很小的试训样本。
50轮,是把这批录音反复学习50遍,不是把几十秒素材变成了更多内容。
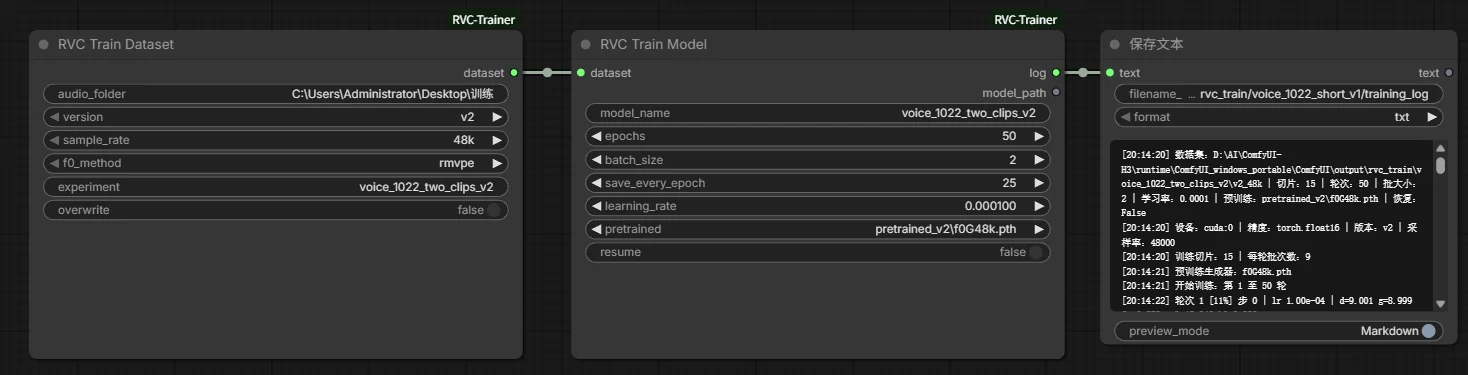 看原图
到了换声环节,上传需要转换的音频,选择训练好的.pth模型和对应的检索文件,运行后就能试听。
跑通不难,但自己的版本听起来还是有很多杂音。我也试了调整检索比例,听感区别不是很大,所以没有继续把所有参数都拧一遍。
这次素材少、内容以说话为主,后面又拿去试唱歌,不能据此判断RVC训练效果就不好;但同样不能因为模型文件成功导出了,就说自己的声音已经克隆好了。
换上现成音色,同一段台词更容易听出差别
接下来,我下载了四款社区音色:云儿青春、雅琳御姐、男声·青年和男声·烟嗓。每款都配上对应的检索索引,分别运行,没有把结果串成一段。
做台词对照时,我又用了同一段约12秒的原音,分别换成这四种音色,再加上自己的训练版。移调统一为0,检索比例先保持0.75。
试听后,我觉得 “男声·青年”在这段里面比较好,自训音色还是有很多杂音。
我把原台词、自训版本、社区“男声·青年”放在一起听,重点听咬字、音色变化和杂音,不只听“像不像换了一个人”。
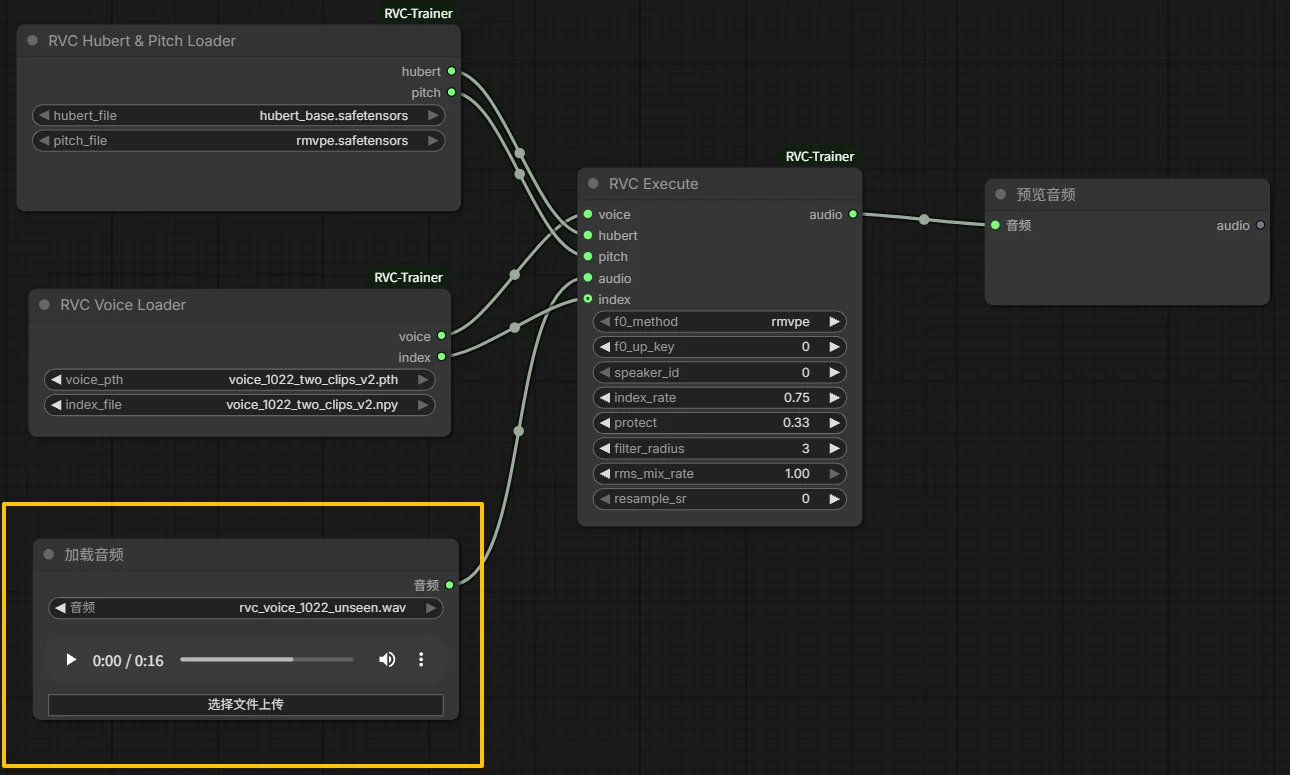 看原图
上图是此前第二版音色测试时的工作流:加载原录音和音色模型,经RVC转换后预览。下面的经典台词对照沿用这套结构,自训模型换成第三版,再与社区“男声·青年”比较。
这是一轮实际听感对照,不是严格的音色排名。社区模型和配套索引一起换了,训练来源也不清楚,我没有给它们打相似度分数。对我这次的任务而言,先用现成音色体验换声,比继续拿几秒录音盲目加训练轮数更有参考价值。
歌曲要先拆人声,不能整首一起“变声”
刚开始我也直接往加载音频里放歌曲。文件能上传,流程也能运行,但完整歌曲里还有鼓、贝斯和其他乐器,不能把“读得进去”当成“适合直接换声”。
后来补上的流程是:先分离歌曲,只转换人声,再混回原伴奏。
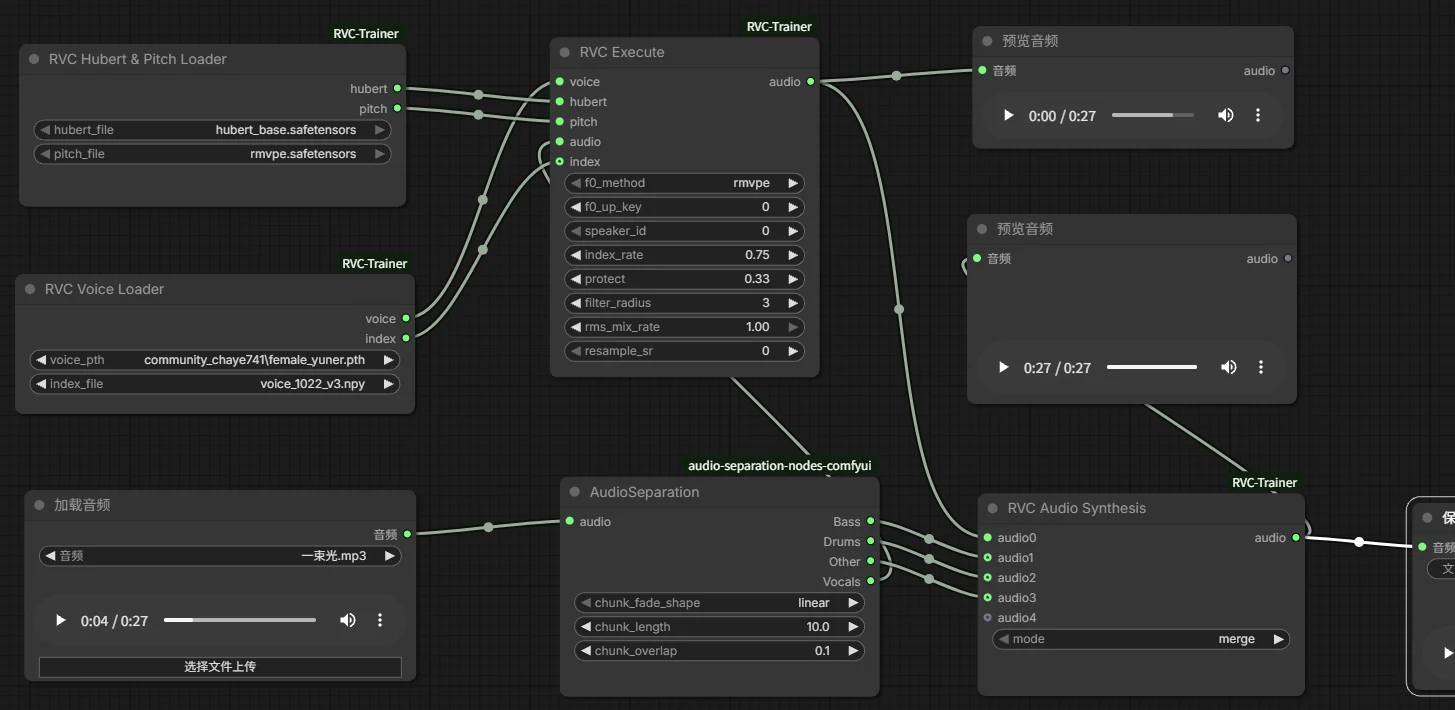 看原图
AudioSeparation会分出Bass、Drums、Other、Vocals四条轨道。把Vocals接入RVC Execute,换声后与前三条伴奏接进RVC Audio Synthesis,模式选merge。不要再把原人声混回去,否则会听见原唱和换声叠在一起。
我保留了两个试听出口:一个只听转换后的人声,一个听混合歌曲。这样人声有问题时,不容易被伴奏盖过去。
这一轮歌曲替换里,有一段我觉得还行,能作为功能展示。不过保存下来的实际配置是云儿青春模型搭配自训v3检索向量,并非它自己的配套索引,所以这里保留这个版本的听感,不拿它证明“云儿青春标准配置最好”。自己复现时,先选同款模型和对应索引,更方便判断问题。
还有一点要说清:我这套工作流里的混合节点会转成单声道,也没有做人声、伴奏的独立音量精调。它够我完成这次体验,还不能当作已经做好混音母带的完整歌曲。
真正卡住我的,是文件格式和索引路径
有一次新录音放进训练文件夹,节点报“没有生成可用的训练切片”。问题不在50轮还是100轮,训练根本还没开始:那两份是M4A,当前环境的音频库无法解码。转成单声道48k WAV后,预处理才正常通过。
下载社区音色时又遇到另一个问题:模型在、索引也在,FAISS却报找不到文件。把索引文件改成英文名,并同步选择项后才跑通。
这里有三条我会留给下次的操作习惯:
- 训练素材先用干净WAV。 这次只有当前环境的M4A解码失败,不等于所有环境都不支持M4A。
- 每换一组素材,另起实验名和模型名。 老版本留着,听差别比凭记忆方便。
- 模型和索引成对选。 新节点安装后还要重启服务;只刷新网页,后台不会自动加载插件。
参数方面,先保持移调0、检索比例0.75,听过再改。升降调是按半音算,改变的是音高;它不是“越大越像”的相似度滑块。
这次我会怎么用它
如果只是想给文稿配音,我仍会先用之前的Qwen路线。RVC更吸引我的,是已经有一段表演时,可以保留原来的说话或唱歌方式,再试不同音色。
ComfyUI-RVC-Trainer把训练和转换接在了同一个工作台里,确实方便继续接分轨、预览和保存。只是流程接得上,不代表短录音就一定能训出好声音。这次自己的训练结果还不满意,我会先用现成音色做更多对照,等有更充足、干净的素材,再认真试自训。
想跟着体验,先拿一段十几秒的干净人声,配一个现成音色跑通;再加训练、歌曲分离,会更容易知道每一步到底改变了什么。
项目:https://github.com/mailzwj/ComfyUI-RVC-Trainer
社区音色:https://huggingface.co/chaye741/RVC-Voice-Models/tree/main/weights
歌曲分离插件:https://github.com/christian-byrne/audio-separation-nodes-comfyui
这次的试听用了电影台词和歌曲片段,这里不放音频。自己公开使用歌曲、原片录音和音色模型时,也要先确认相应的使用范围。
智能搭子 · 和你一起把AI真正用起来 · 真实体验 · 客观判断 · 持续探索
测试环境
训练耗时包含预处理和保存,是这一轮小样本的记录,不当作硬件基准。
- 训练设置
- v2 · 48k · RMVPE
- 首轮素材
- 约 27.5 秒
- 训练轮数
- 50 轮 · batch size 2
- 首轮训练
- 约 2 分 35 秒
- 换声参数
- 移调 0 · 检索比例 0.75
- 实测日期
- 2026-10-23
来源与使用范围
用到的素材和工具来自不同作者,使用前请看清各自的范围。
可以这样用
用自己的声音、或已经获得授权的声音训练和换声;节点按 MIT 许可使用。
不要这样用
没经过本人同意,用别人的声音冒充本人说话或唱歌;社区音色模型页没写训练来源和许可,别直接拿去商用;歌曲、电影台词换声后的版本公开传播。
训练与换声节点:mailzwj/ComfyUI-RVC-Trainer;歌曲分离:christian-byrne/audio-separation-nodes-comfyui;社区音色:chaye741/RVC-Voice-Models。
写在最后
文中的结果都是我在自己电脑上实测的,换一台电脑、换个软件或模型版本,结果可能不一样。
模型和工具的版权归原作者,本站只链接官方下载地址;可下载的工作流和脚本按现状分享,运行前请先看一遍内容,重要文件先备份。
声音克隆、换脸换装、AI 生成的图片、视频和音乐,请只用你自己的或已经获得授权的素材,发布和使用时遵守法律法规和平台规则。
如有内容涉及侵权,请通过公众号「智能搭子」私信联系我,核实后会及时删除。