 智能搭子
我用SeedVR2修了4张图:变清晰了,却不像原来?
大家好,我是你的智能搭子阿洁。
旧照片一放大,轮廓和细节都糊在一起。最近我找了一个能在ComfyUI里运行的开源项目SeedVR2,想看看它能把图片修到什么程度。这次我在RTX 5070 12GB显卡、约32GB内存的电脑上安装节点和模型,连续处理了4张不同的图。
结果不完全一样:有的只是边缘稍微清楚些,有的改善很明显;人像虽然变清晰,却让我觉得像被美白过,少了照片原来的自然感。
先把它装进ComfyUI
我使用的是本机ComfyUI 0.37.0、Python 3.13.14和PyTorch 2.13.0+cu130。当前这套环境没有启用ComfyUI Manager,所以这次用Git手动安装。节点仓库是numz/ComfyUI-SeedVR2_VideoUpscaler,下载到正在使用的ComfyUI的custom_nodes目录,随后用这套便携环境自带的Python安装仓库的requirements.txt。从开始打点到下载完代码并查出提交版本约3.6秒;依赖安装阶段约28秒,后者用了部分本地缓存,并不是全部从网络重新下载。
具体操作是先进入正在运行的ComfyUI根目录,下载节点,再用同一套便携包里的Python装依赖。下面是我这次使用的命令;路径需按自己的安装位置调整:
Set-Location "D:\AI\ComfyUI-H3\runtime\ComfyUI_windows_portable\ComfyUI"
git clone --branch main https://github.com/numz/ComfyUI-SeedVR2_VideoUpscaler.git custom_nodes/seedvr2_videoupscaler
Set-Location ..
.\python_embeded\python.exe -m pip install -r .\ComfyUI\custom_nodes\seedvr2_videoupscaler\requirements.txt
这里有个值得记住的小插曲:依赖装好后,我直接启动了一次ComfyUI,却看到“Database is locked”和“Port 8188 is already in use”。原来旧的ComfyUI实例还在运行。保存原工作流、关闭旧进程后重新启动,SeedVR2节点才在8188端口正常加载。启动日志里的SageAttention、Flash Attention和Triton红叉只是可选加速组件缺失;本次用的是PyTorch的SDPA,没有为它们额外安装依赖。
节点能加载还不算装完,运行还需要模型。我从项目登记的Hugging Face来源分别下载了seedvr2_ema_3b_fp8_e4m3fn.safetensors和ema_vae_fp16.safetensors,放到ComfyUI/models/SEEDVR2。主模型约3.39 GB,下载阶段约3分18秒;VAE约501 MB,约29秒。两份文件合计约3.89 GB,下载加切换命令约3分47秒。下载后两份文件的哈希都与节点登记值一致。
这套环境的安装路径和每一步终端输出我都留了记录。读者使用其他ComfyUI版本或安装位置时,应该以自己正在运行的环境为准,尤其不要把依赖装进系统里另一个Python。
四张图,四种不同结果
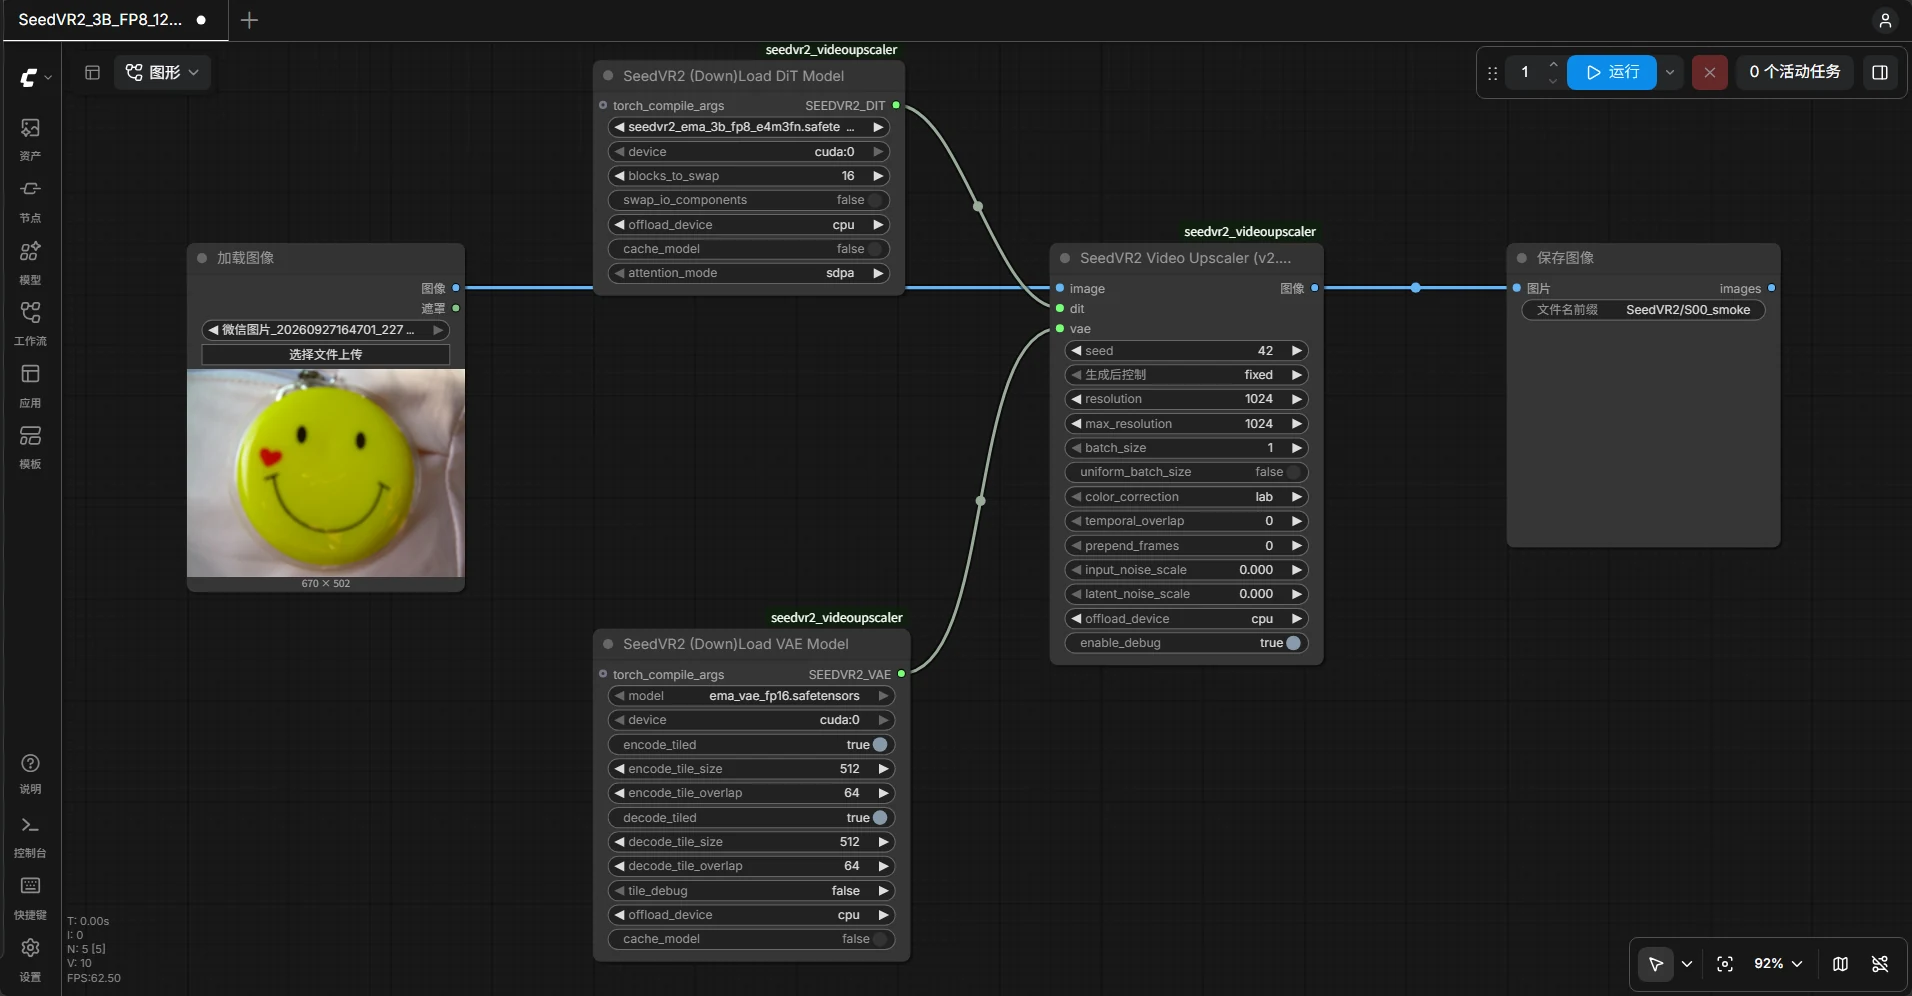
测试统一使用SeedVR2 3B FP8模型、固定种子42、SDPA、16个BlockSwap块、CPU卸载和VAE分块处理。输出最长边设为1024像素。首次运行模型准备耗时更长,后续运行复用了模型配置;四张图的输入尺寸也不同,因此下表只记录各自任务的实测时间,不用它们比较加速幅度。
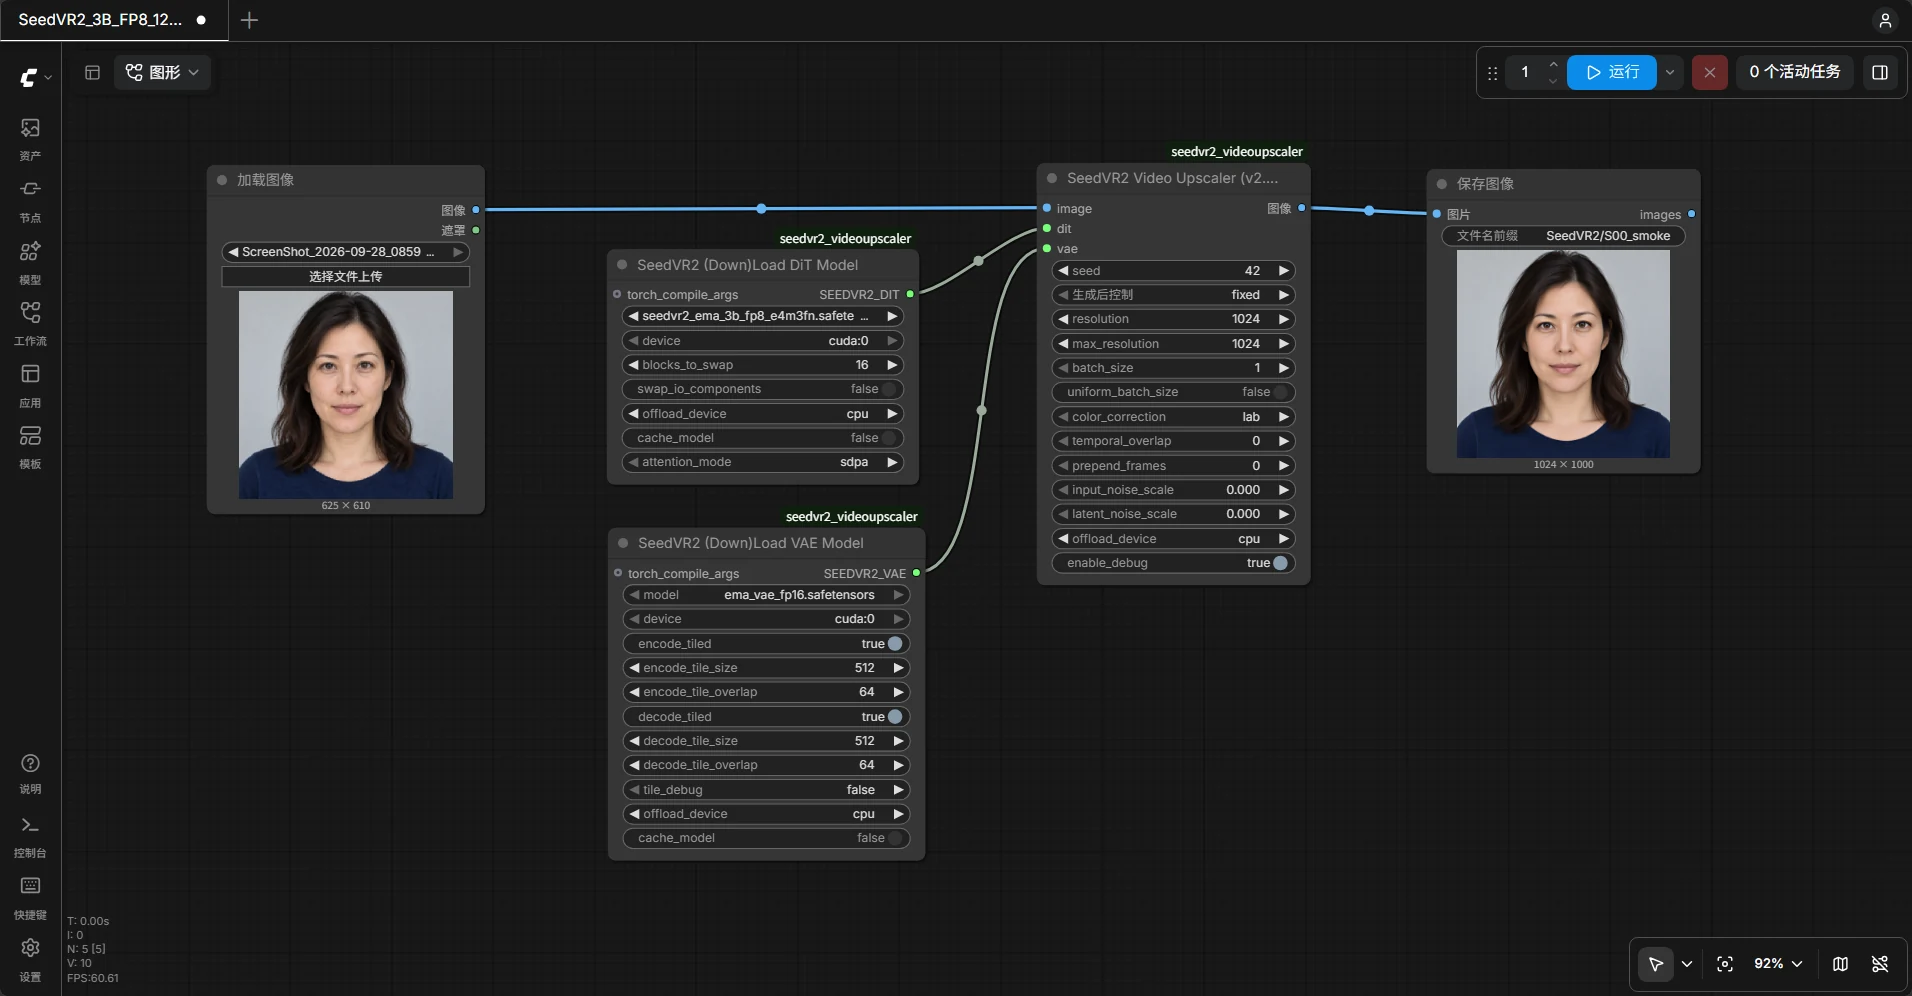
这是我第一次试跑时的ComfyUI工作流:左边加载图片,上下两个节点分别加载DiT主模型和VAE,中间的SeedVR2节点处理图片,最后交给保存图像节点。截图里也能看到这次使用的主要参数。
 看原图
| 图片 | 输入→输出 | 整条工作流耗时 | 我看到的结果 |
|---|---|---|---|
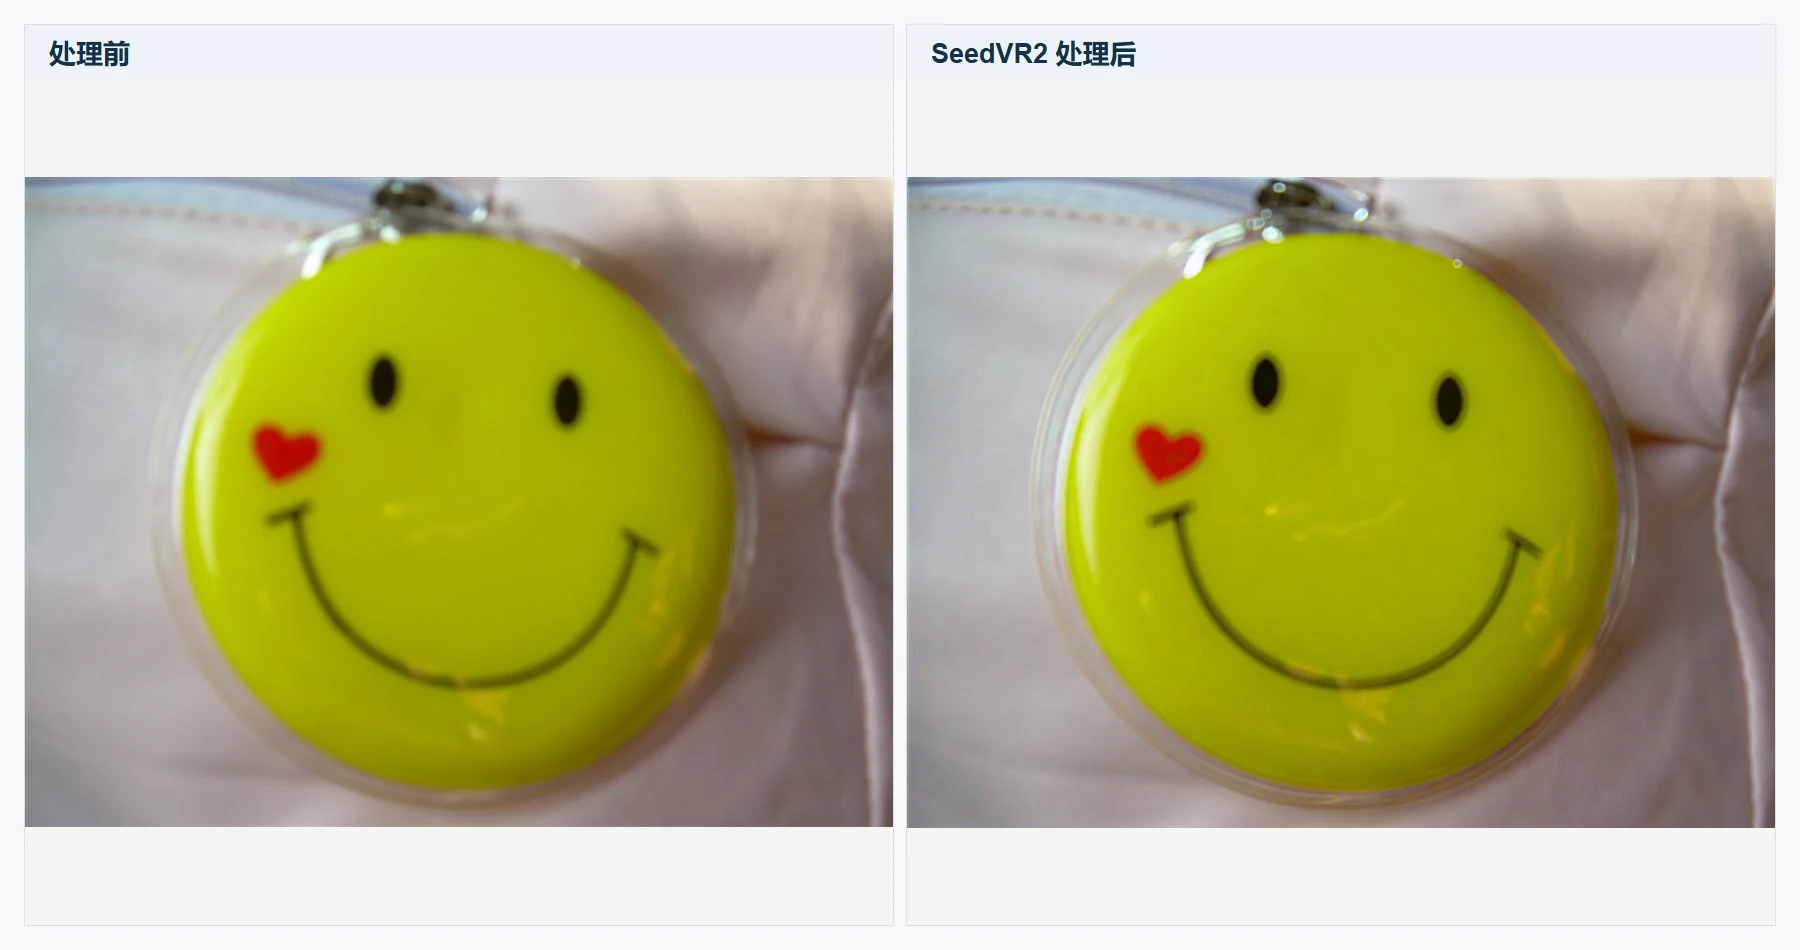
| 模糊的笑脸挂件 | 670×502→1024×768 | 12.18秒 | 红心、眼睛和透明外壳轮廓有所增强,边缘仍模糊 |
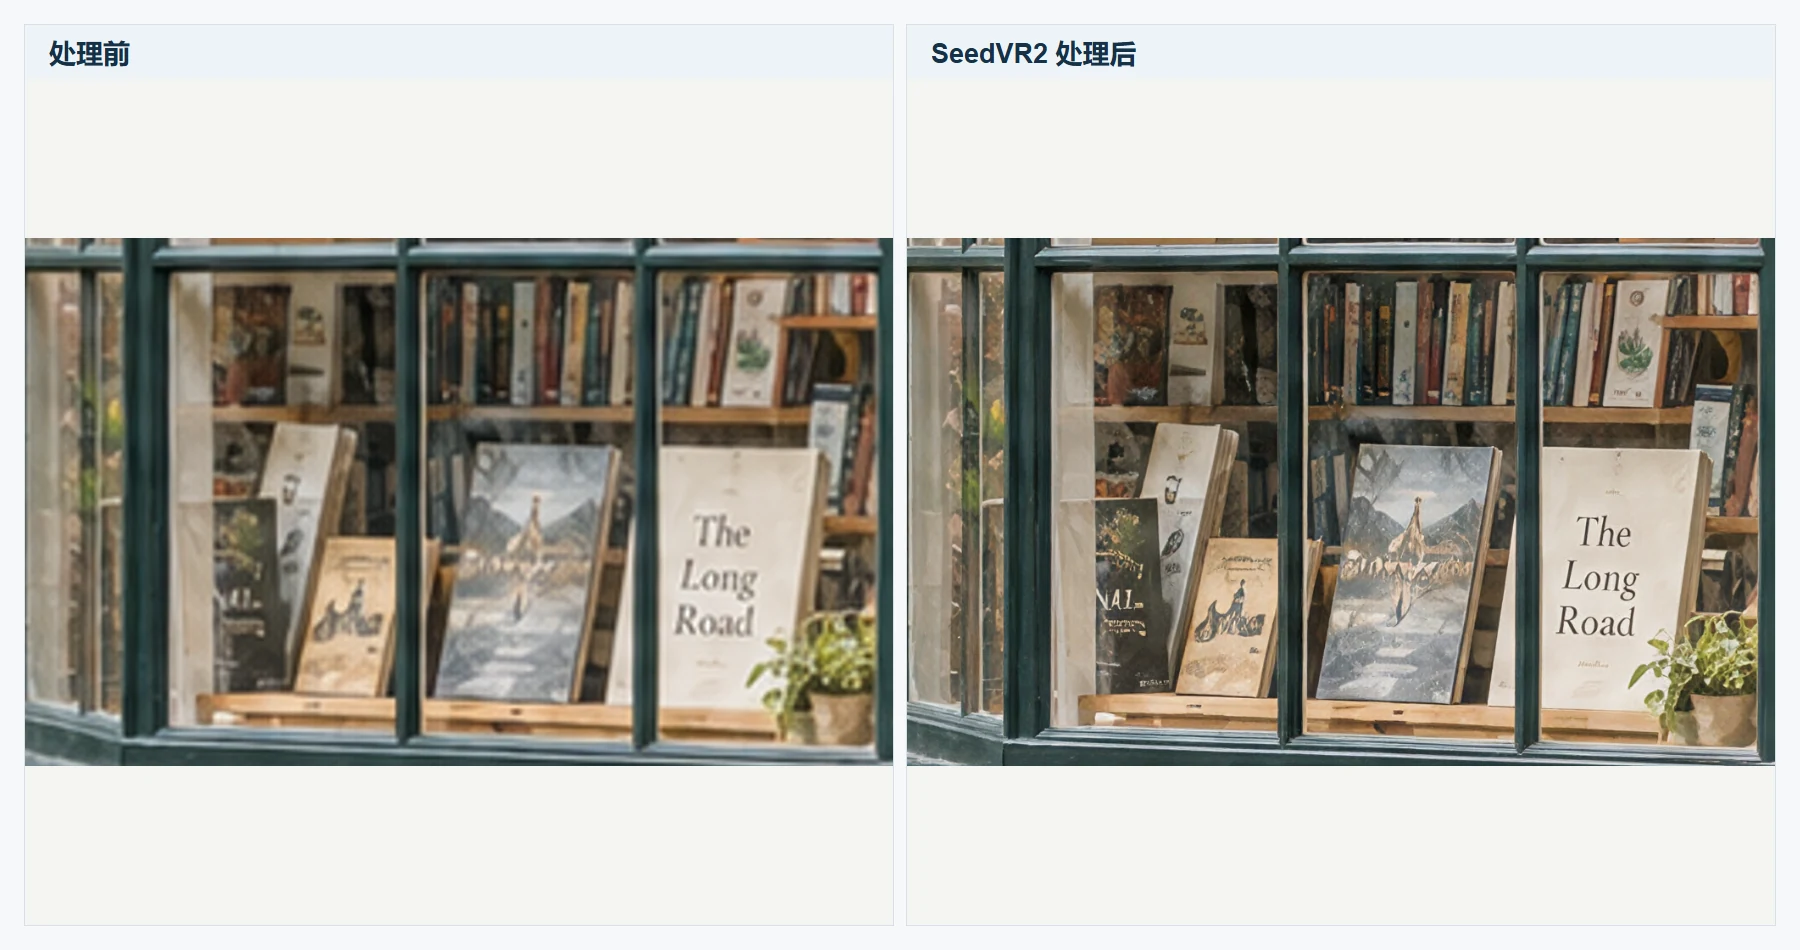
| 书店窗格截图 | 1073×653→1024×622 | 6.52秒 | 明显更清晰,旁边绿植有点失真感 |
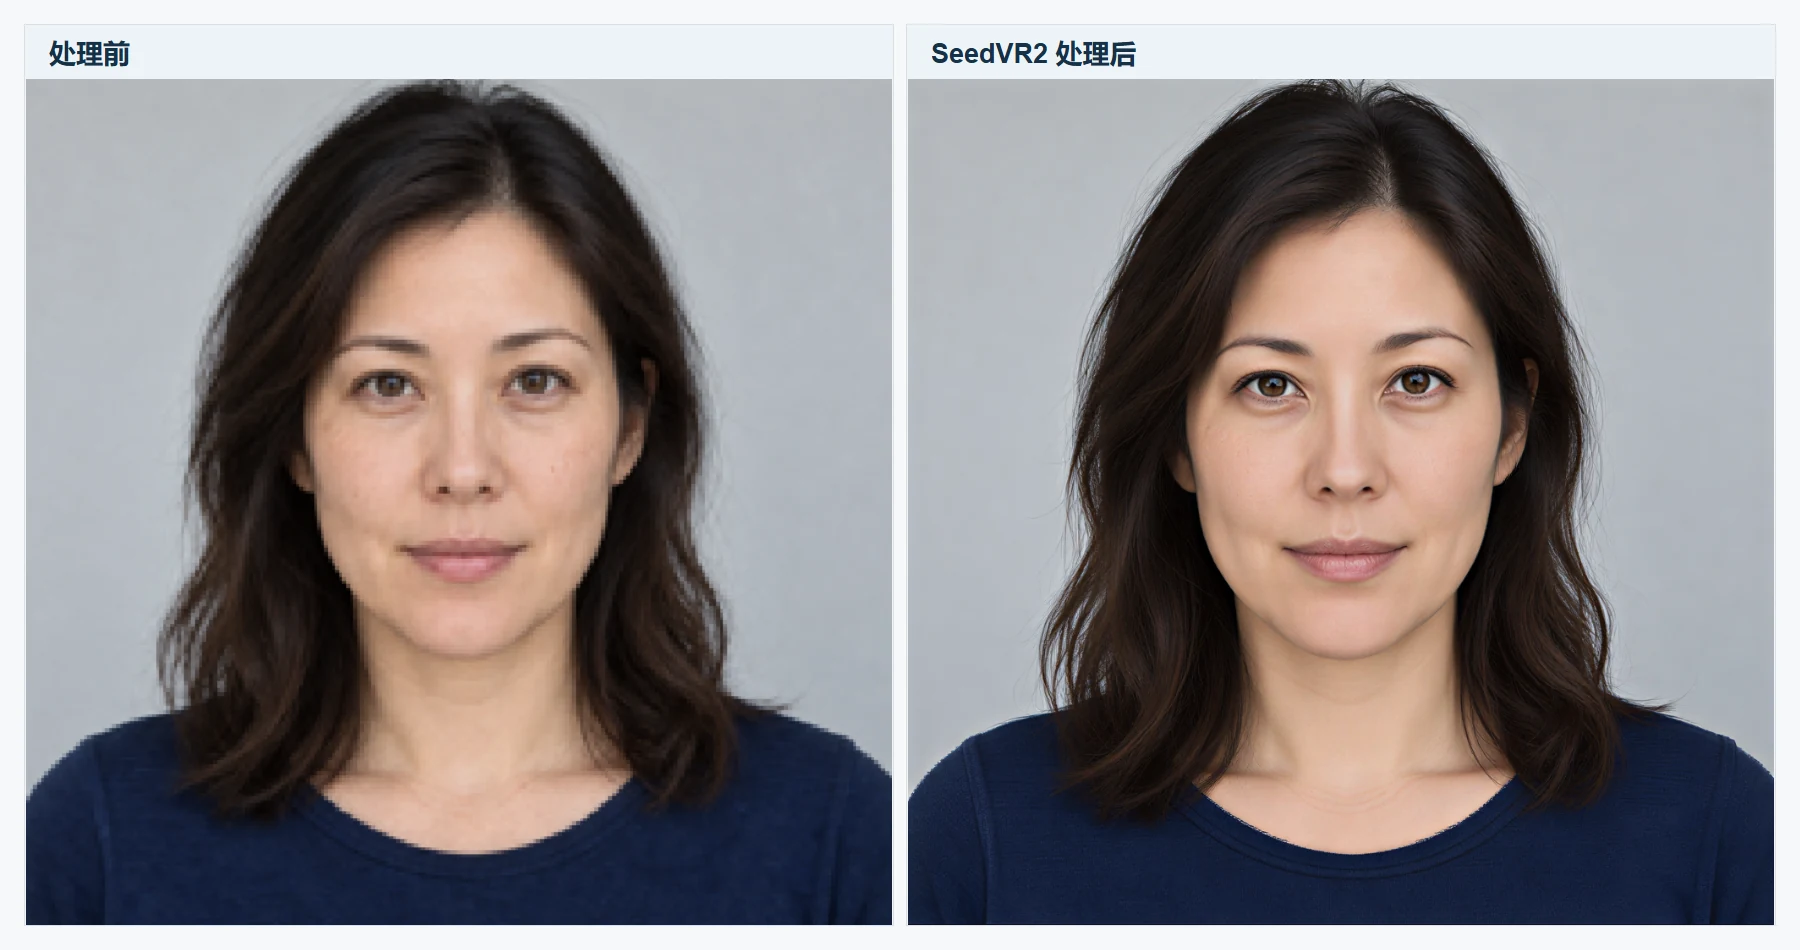
| AI生成的人像截图 | 625×610→1024×1000 | 7.74秒 | 变清晰,但斑点和原来偏黄的肤色没了,像经过美白,照片感下降 |
| 找来的展馆旧照 | 670×503→1024×768 | 6.72秒 | 清晰了一些,展牌小字没有恢复成可辨文字 |
第一张笑脸挂件很容易看出区别:黑色眼睛、红心和外壳线条比原图更明确,但它并没有把原本模糊的边缘真正救清楚。对这类照片,我会把结果叫作轮廓增强,而不是“修回高清原片”。
 看原图
书店那张图更有意思。清晰参考图是AI生成的,我把窗格局部放大后截屏,再把截图交给SeedVR2。书名“The Long Road”和窗框变得更容易看清,绿植却让我觉得有点失真。因为这张输入是屏幕截图,而且输出宽度还从1073缩到1024,它证明的是局部截图的观感改善,不能作为“放大了两倍”的例子。
 看原图
人像也来自AI生成的虚构亚洲成年人形象。我把同一张参考图截成低清输入,修复后五官清楚了,可脸上的斑点和原来偏黄的肤色也淡去了。我的感觉是,它好像被PS美白过,不像拍出来的照片那么自然。对人像来说,清晰度提高并不自动等于保留原来的面部特征和肤色。这张图不是现实人物或真实旧照,因此我只把它作为这次人像测试的一个样本。
人像这一轮的ComfyUI界面里,左边是625×610的输入截图,右边保存节点显示1024×1000的输出;处理参数与前面一致。
 看原图
 看原图
最后,我又找来一张展馆里的装甲车辆旧照。修复后车体、炮管和地面确实清晰了一些,但展牌原本看不清的小字并没有变成可辨的内容。我不会把放大后看起来更锐利的笔画,当作原本就存在的真实文字。
这张旧照来源不明,这里不放它的处理前后图,只保留文字记录。
我会用它做什么
这四次测试让我愿意把SeedVR2当作图片整理时的一个增强工具:先试试看轮廓、材质和整体观感能否改善,再把输出和原图放在一起检查。遇到人像、文字或需要保留原貌的照片,我会看得更仔细;如果肤色、斑点或物体细节被改了,就不能只因为“更清楚”而直接采用。
本次是3B FP8模型和这一套12GB显卡参数下的4张小样本,没有比较其他模型,也没有验证真实道路、文档等其他场景。终端记录的显存分配峰值约2.35—2.38GB,是CPU卸载和分块设置下的节点统计,不能推成“只要3GB显卡就能跑”。
智能搭子 · 和你一起把AI真正用起来 · 真实体验 · 客观判断 · 持续探索
模型清单
只给官方下载页,本站不转存模型。按完整文件名选择,不用下载整个仓库。
SeedVR2 3B FP82 个文件,约 3.89GB
阿洁提醒:依赖要装进正在运行的那套 ComfyUI 自带的 Python,别装进系统里另一个 Python。
测试环境
耗时是整条工作流从开始到保存的时间;四张图输入尺寸不同,不用来比较速度。
- 显卡
- RTX 5070 12GB
- 内存
- 约 32GB
- ComfyUI 核心
- 0.37.0
- PyTorch
- 2.13.0+cu130
- 每张图
- 约 6.5–12.2 秒
- 实测日期
- 2026-09-28
来源与使用范围
用到的素材和工具来自不同作者,使用前请看清各自的范围。
可以这样用
节点和模型按各自的开源许可使用;拿自己的照片试,和原图并排检查后再用。
不要这样用
把放大后“长出来”的文字、细节当成原图里真实存在的信息;拿修复结果冒充原始照片。
节点:numz/ComfyUI-SeedVR2_VideoUpscaler;模型:numz/SeedVR2_comfyUI。文中书店和人像测试图为 AI 生成。
写在最后
文中的结果都是我在自己电脑上实测的,换一台电脑、换个软件或模型版本,结果可能不一样。
模型和工具的版权归原作者,本站只链接官方下载地址;可下载的工作流和脚本按现状分享,运行前请先看一遍内容,重要文件先备份。
声音克隆、换脸换装、AI 生成的图片、视频和音乐,请只用你自己的或已经获得授权的素材,发布和使用时遵守法律法规和平台规则。
如有内容涉及侵权,请通过公众号「智能搭子」私信联系我,核实后会及时删除。